Logo de SAASF

Le chapitre 5

Contenu

Les anneaux et les corps

Des structures algébriques avancées

Qu'est ce qu'est un anneau ?

L'anneau est une structure algébrique très importante, et la première que nous introduirons avec deux lois de compositions internes. En algèbre, un anneau est une structure algébrique définie sur un ensemble, avec deux lois de compositions internes : une formant un groupe abélien, et une formant un monoïde, distributive par rapport à la première. Rappelons toutes les propriété nécéssaire, pour un anneau "A" muni d'une opération "+" et ".".

A =(E,¤,.)

La structure (A, ¤) est un groupe abélien.

"¤" est associative :

∀a,b,c∈E,(a ¤ b) ¤ c =a ¤ (b ¤ c)

"¤" permet à E d'admettre un neutre :

∀a ∈E,∃m ∈E,a ¤ m =e

"¤" permet à chaque élément de E d'admettre un opposé :

∀a ∈E,∃o ∈E,a ¤ o =a

"¤" est commutative :

∀a,b ∈E,a ¤ b =b ¤ a

La structure (A, .) est un monoïde.

"." est associative :

∀a,b,c∈E,(a . b) . c =a . (b . c)

"." permet à E d'admettre un neutre :

∀a ∈E,∃n ∈E,a . n =e

La loi "¤" est algébriquement lié à ".".

"." est distributive à gauche par rapport à "+" :

∀a,b,c∈E,a . b ¤ a . c =a . (b ¤ c)

"." est distributive à droite par rapport à "+" :

∀a,b,c∈E,b . a ¤ c . a =(b ¤ c) * a

Cependant, nous pouvons affaiblir ce concept avec ce que l'on appelle le "pseudo-anneau". Un pseudo-anneau est un anneau où la deuxième loi de composition n'admet pas forcément un neutre. Dans ce cas, "(A, .)" n'est plus un monoïde, mais un demi-groupe.

Chez certains auteurs, le concept d'anneau seul représente ce que l'on a défini comme "pseudo-anneau" (qu'ils n'emploient donc pas). Or, ces mêmes auteurs ont un autre terme pour les anneaux donc la deuxième loi admet un neutre : anneau "unitaire" (ou anneau "unifaire"). Ici, nous n'utiliserons pas ce terme, et nous considérerons qu'un anneau a forcément un neutre par la multiplication, mais sachez que ce terme existe.

Si la deuxième loi est "." commutative, alors l'anneau est dit "commutatif". La branche de l'algèbre qui étudie les anneaux commutatifs se nomment "l'algèbre commutative".

∀a,b ∈E,a . b =b . a

Si l'anneau ne comporte pas de diviseur de 0 (autre que 0), il est dit "intègre".

¬(∃a,b ∈E*,a * b =0)

L'exemple le plus simple est l'anneau formé par "Z", et par l'addition et la multiplication sur "Z". Cet anneau est commutatif et intègre.

(Z,+,.)

On peut aussi citer ceux formé avec "Q" et "R".

(Q,+,.)
(R,+,.)

Les sous-anneaux

Comme il existe des sous-groupes de groupes, il existe des sous-anneaux d'anneaux. Un sous-anneau A d'un anneau B est un anneau sur un sous-ensemble de l'ensemble de B. Leurs propriétés sont très proches de celles des sous-groupes. En fait, il est stable par l'addition, par la multiplication et admet un neutre par l'addition et la multiplication (les mêmes que l'anneau qui le contient). Quand on pense à sous-anneau, on peut penser à "(2Z, +, .)", qui serait un sous-anneau de "(Z, +, .)". Déjà, nous avons démontré à plusieurs reprises que "2Z" est inclut dans "Z".

∀a,a ∈2Z ⇒a ∈Z

De plus, nous avons déjà démontré que le groupe "(2Z, +)" est un sous-groupe de "(Z, +)" : il est stable par l'addition et contient le neutre de l'addition. Finalement, la stabilité par la multiplication est aussi assez simple à prouver.

∀a,b ∈2Z,∃c,d ∈Z,a =2 * c,b =2 * d
a * b =(2 * c) * (2 * d) =2 * (c * 2 * d) =2 * e,e =(c * 2 * d)

Donc, l'anneau "(2Z, +, .)" respecte presque toutes les propriétés. Malheureusement, il n'y a pas d'élément neutre de la multiplication dans "2Z" (puisque "1" n'est pas dedans) : il ne s'agit donc pas d'un sous-anneau de (Z, +, .). Cependant, il est vrai que si l'on considère le pseudo-anneau "(Z, +, .)", alors "(2Z, +, .)" en est un sous-pseudo-anneau (pour rappel, dans les pseudos-anneaux, le neutre multiplicatif n'est pas obligatoire). Par contre, comme "(R, +, .)" est un anneau, et que "(Z, + .)" l'est aussi, et que "Z" est inclus dans "R", alors "(Z, + .)" est un sous-anneau de "(R, + .)".

Z ⊆R

Comme pour les sous-groupes engendrés, il existe un moyen de créer des "sous-anneaux" engendrés. En effet, pour un anneau "(A, +, .)", le sous-anneau engendré par une partie "B" de "A" représente l'anneau sur l'ensemble contenant tous les éléments obtenables avec les opérations "+" et "." et avec les éléments de "B". Cependant, il y a quelque chose d'important à rajouter : l'inverse de "+" (généralement "-") fait partie des opérations licites pour engendrer un anneau, mais pas l'inverse de "." (généralement "/"). Cela est dû au fait qu'il peut exister des éléments de l'anneau n'ayant pas d'inverse pour l'opération ".". L'ensemble d'un sous-anneau de "A" engendré par "B" se note généralement :

B

Bon, on peut cependant avoir un problème : imaginez le sous-anneau engendré par "{2}" dans "(Z, +, .)" : il n'existe aucune moyen d'obtenir le neutre de la multiplication avec "2", "+", "-" et "*" (pour rappel, "/" est interdit). En fait, on rajoute toujours le neutre multiplicatif de l'anneau dans la partie si elle n'est pas déjà présente de base. Donc, l'anneau engendré par "{2}" est l'exact même que l'anneau engendré par "{1, 2}".

{2}={1,2}

Les idéaux et les anneaux quotients

Il est possible de modifier un peu cette définition, pour obtenir un concept assez similaire : les idéaux. Un idéal "A" d'un anneau "B" est un sous-ensemble de "B" stable par la première loi de "B", mais aussi stable par la deuxième loi par tous les éléments possibles de "B". Il s'agit donc d'un sous-ensemble de l'anneau qui est un sous-groupe pour la première loi, et où l'utilisation de la deuxième loi entre les éléments de l'anneau et les éléments de l'idéal donne toujours un élément de l'idéal. Cependant, il n'est pas obligé qu'un idéal contienne un neutre par la deuxième : il n'est donc pas obligatoirement un sous-anneau. Il y a néanmoins quelque chose à prendre en compte : si l'utilisation de la deuxième loi entre les éléments de l'anneau PUIS les éléments de votre partie donne toujours un élément de la partie, on parle d'idéal à gauche. À l'inverse, si l'utilisation de la deuxième loi entre les éléments de votre partie PUIS les éléments de l'anneau donne toujours un élément de la partie, on parle d'idéal à droite. Cela est utile si deuxième loi n'est pas commutative. Pour un idéal à gauche "A" d'un anneau "B" (en considérant que "A" est un sous-groupe de "B" par la première loi), on peut écrire :

∀b ∈B,{∀a ∈A,b * a ∈A}

Et pour un idéal à droite "A" d'un anneau "B" (en considérant que "A" est un sous-groupe de "B" par la première loi), on peut écrire :

∀b ∈B,{∀a ∈A,a * b ∈A}

Ici, si votre idéal est un idéal à droite et un idéal à gauche, on parle d'idéal bilatère. Cela ne veut pas forcément dire que "a * b = b * a", mais on est sur que les deux appartiennent à l'idéal. Cependant, si votre anneau est commutatif, tout idéal à gauche et à droite est un idéal bilatère, et "a * b = b * a". Encore pour un idéal bilatère "A" d'un anneau "B" (en considérant que "A" est un sous-groupe de "B" par la première loi), on peut écrire :

∀b ∈B,{∀a ∈A,a * b ∈A}

Prenons un exemple très simple : pour tout "n" dans "N", "nZ" est un idéal de "(Z, +, .)". La démonstration est extrêmement simple : comme tout élément de "nZ" s'écrit sous la forme "n * c" (avec "c" un nombre entier décimal quelconque), le multiplier par un élément de l'anneau revient à multiplier "c" par un élément de l'anneau, ce qui donne "n" multiplié par quelque chose : un élément de "nZ".

∀a,∈nZ,∃c ∈Z,a =n * c
∀e ∈Z,a * e =n * c * e =n * (c * e)

Il existe cependant deux idéaux très simples pour tout anneau : les idéaux triviaux. Un idéal A d'un anneau B est idéal trivial si il est soit égal à tout "B", soit égal à l'élément nul par la première loi de "B". Les idéaux qui ne sont pas des idéaux triviaux sont nommés de idéaux propres.

Comme pour les anneaux, il existe des idéaux engendrés. Un idéal "I" d'un anneau "A" est dit engendré par une partie "P" quand "I" représente tous les éléments ostensibles avec "P" respectant les propriétés définissant un anneau. En d'autres termes, il s'agit du "plus petit" idéal possible dans "A" contenant "P" (tous les autres idéaux contenant "P" sont des sur-ensembles de "I"). L'idée pour l'obtenir est donc de prendre "P", et de lui ajouter le minimum d'éléments nécessaires permettant pour faire du sous-ensemble de "P" un idéal. Encore une fois, on peut parler d'idéal engendré à gauche ou à droite. Pour le définir correctement, imaginons un ensemble "E" contenant toutes les utilisations de la deuxième loi entre un élément de "A" et un élément de "P".

E ={x ∈A | ∃(y,z) ∈A ×P ∧x =yz}

Cette ensemble représente donc toutes les utilisations de la seconde loi, qui doivent apparaître dans l'idéal. Nous devons maintenant compléter cet ensemble, en le rendant stable par la première loi. Pour cela, l'idée est donc de créer un ensemble qui contient toutes les sommes possibles d'éléments de "E". Or, toutes ces sommes sont composés d'éléments de "E" dans un ordre précis, et toutes les compositions possibles d'éléments de "E" sont en fait des n-uplets de "E". En prenant le symbole sigma majuscule comme la répétition de la première loi, on peut noter :

I ={x ∈A | ∃n ∈N,∃(q1,q2,...,qn) ∈En,x =∑k=1nqk}

Dans le cas à droite, nous devons redéfinir un ensemble comme "E", et on peut noter :

F ={x ∈A | ∃(y,z) ∈A X P ∧x =yz}
J ={x ∈A | ∃n ∈N,∃(q1,q2,...,qn) ∈Fn,x =∑k=1nqk}

Dans le cas où vous voulez les deux, vous devez redéfinir un nouvel ensemble, où la deuxième loi est utilisée dans les deux sens.

G ={x ∈A | ∃(w,y,z) ∈A X A X P ∧x =wyz}
K ={x ∈A | ∃n ∈N,∃(q1,q2,...,qn) ∈Gn,x =∑k=1nqk}

Grâce aux idéaux, on peut définir un type d'anneau très spécial et pratique : les anneaux quotients. L'anneau quotient d'un anneau "A" et d'un idéal bilatère "I" représente un nouvel anneau sur l'ensemble de "A" quotienté par la relation d'équivalence reliant de manière calculatoire chaque élément de "I" avec les éléments de "A". Il s'agit donc d'une version des groupes quotients avec des anneaux. Ici, définissons rigoureusement cette relation d'équivalence, et expliquons là. Posons cette relation "~" :

∀x,y ∈A,x ~ y ⇔x - y ∈I

Ici, vérifions que cette relation est une relation d'équivalence. Déjà, la symétrie est très rapide : il existe un élément de l'anneau qui, quand on le multiplie à un élément "e", donne l'opposé de "e" par la premère loi. Dans le cas des entiers relatifs, cet élément serait "-1" (nous le nommerons comme ceci). En utilisant les propriétés algébrique des anneaux, on peut utiliser cet élément et vérifier la symétrie ainsi :

∀x,y ∈A,x ~ y ⇔x - y ∈I ⇔(x - y) * -1 ∈I ⇔y - x ∈I ⇔y ~ x

Deuxièmement, prouvons la réflexivité. Cette propriété est immédiate : elle équivaut à dire que "x - x" appartient à "I", ce qui est obligatoire car tout idéal d'un anneau contient le neutre de la première loi.

∀x,y ∈A,x ~ x ⇔x - x ∈I ⇔0 ∈I

Finalement, prouvons la transitivité. Pour cela, posons trois éléments en relation entre eux, et démontrons algébriquement la transitivité.

∀x,y,z ∈A,x ~ y ∧y ~ z ⇔x - y ∈I ∧y - z ∈I ⇒(x - y) +(y - z) ∈I ⇒x - z ∈I ⇒x ~ z

Donc, "~" est une relation d'équivalence, et l'on peut quotienter "A" par "~" pour obtenir un ensemble quotient. Maintenant, définissons deux lois qui donnent une structure d'anneau à cet ensemble quotient. La première (que nous noterons "+") sera une addition très similaire à l'addition dans un anneau tout court :

∀m,n ∈E/~,∃x,y ∈A,∃a,b ∈I,m =x +a,n =y +b
m +n =[x +a] +[y +b] =[x +y]

On peut voir que les propriétés de cette nouvelle première opération sont exactement les mêmes que celles de la première opération de l'anneau. Maintenant, définissons la multiplication :

m * n =[x +a] * [y +b] =[x * y]

Nous obtenons donc un ensemble avec des propriétés calculatoires d'un anneau. Donc, l'ensemble quotient a une structure d'anneau (nous pouvons donc donc l'appeler anneau quotient). Généralement, comme pour les groupes quotients, cet anneau sera noté avec le nom de l'anneau, puis le symbôle "/", suivit du nom de l'idéal utilisé.

A/I

Prenons l'exemple le plus utilisé : l'anneau "Z/nZ". En effet, pour rappel, "(Z, +, *)" est un anneau, et pour tout nombre entier naturel "n", "nZ" est un idéal bilatère de cet anneau. Donc, on peut construire l'anneau quotient de "Z" par "nZ", que l'on note "Z/nZ".

/n

Les anneaux principaux et euclidiens

Les anneaux principaux et euclidiens sont des anneaux extrêmement importants pour étudier le concept de division en mathématiques, de manière plus avancée qu'avec des nombres entiers.

Qu'est ce qu'est un corps ?

Un corps représente une version des anneaux possédant plus de propriétés. En effet, un corps est un anneau où chaque élement (non-nul) possède un inverse par la deuxième opération. La deuxième opération permet donc de former un groupe avec l'ensemble associé au corps.

K =(E,+,.)

La structure (E*, .) est un groupe.

∀a ∈E*,∃b ∈E,a . b =n

Comme pour les anneaux, un corps dont la deuxième loi est commutative est nommée un corps commutatif. Selon les auteurs, tous les corps sont commutatifs, mais nous allons dire ici que seul les "corps commutatifs" le sont.

∀a,b ∈E,a . b =b . a

Grossièrement, un corps est une structure algébrique où l'on peut utiliser les opération "+", "-", "*" et "/". L'exemple le plus simple est le corps formé par "Q", et par l'addition et la multiplication sur "Q".

(Q,+,.)

Le corps le plus utile est probablement le corps formé par "R", et par l'addition et la multiplication sur "R".

(R,+,.)

Il est possible de trouver des corps qui contiennent d'autres corps, grâce au concept d'extension de corps. Une extension de corps "K" est un couple composé d'un corps "L" tel que "K" soit un sous-corps de "L", et d'un morphisme de "K" dans "L". Généralement, quand on parle d'extension, on parle juste du corps, et pas du morphisme. L'exemple le plus simple est le corps "(R, +, .)", qui est une extension du corps "(Q, +, .)".

Les polynômes

Qu'est ce qu'est un polynôme ?

Plus tôt, nous avons à de multiples reprises envisagé des fonctions de la forme "a * x ² + b * x + c". Cependant, ce concept se généralise assez facilement, grâce aux polynômes. Un polynôme est une forme précise de formule mathématique, représentant la somme de produit d'éléments (nommés coefficients) dans un anneau (ou, à fortiori, un corps) quelconque par des variables (nommés indéterminées) élevés à des exposants représentant des nombres naturels. Ici, il faut comprendre que cette indéterminée est un objet "formelle" utilisée comme une variable normale. On note généralement ce genre d'indéterminé avec des lettres majuscules. Donc, dans le corps usuel des réels, un polynôme peut très bien être :

P =3X4+2X2- 1

Il existe cependant une définition bien plus rigoureuse : un polynôme représente une suite finie d'éléments de la structure dans lequel il est défini, où l'écriture formelle reviendrait à sommer chaque élément de la suite, multiplié par l'indéterminée à l'exposant l'indice de l'élément actuel. Dans ce cas, notre polynôme vue plus haut serait la suite finie "(-1, 0, 2, 0, 3, 0, 0, 0...)" (pour rappel, dans une suite de ce genre, à partir d'une certaine valeur, toutes les valeurs sont nulles). Cela nous permet donc d'utiliser la terminologie d'une suite, et (dans le cas où le dernier élément non-nul de la suite soit à l'indice "n") d'écrire :

P =∑k=0npkXk

Une confusion assez courante est de mélanger le concept de polynôme et de fonction. En effet, un polynôme n'est qu'une formule, et pas une application, il ne s'agit donc pas directement d'une fonction. Cependant, il est assez courant de définir une fonction via un polynôme, en définissant l'expression de la fonction comme le polynôme étudié. Dans ce cas, on parle de fonction polynomiale, et on l'a note généralement avec le même nom que le polynôme associé, avec une petite vaguelette sur le haut (pour un polynôme "P", cette vaguelette se dit avec le mot "tilde", ce qui donne "P tilde").

P =3 * 2+2 * x - 1
: R ⟶R,x ⟶3 * 2+2 * x - 1

Les polynômes possèdent une arithmétique assez simple et intuitive. Déjà,il est possible d'additionner deux polynômes, en utilisant la première loi de composition du corps des coefficients des polynômes. Les lois restent exactement les mêmes que pour des indéterminées classiques,et les propriétés du corps sont conservés avec les polynômes (groupe additif abélien). La définition de cette multiplication est assez simple : on additionne entre eux les coefficients partageant des inconnus élevés au même exposant (d'où on en déduit les propriétés additives des polynômes).

∑x=0makXk+∑x=0nbkXk=∑x=0max(m,n)(ak+bk)Xk
(3 * X3+2 X2- 4 * X+2) +(2 * X4- 2 X2+3 * X+5) =(2 * X4+3 * X3- X+7)

En plus,il est possible de multiplier deux polynômes, en utilisant la seconde loi de composition du corps des coefficients des polynômes. Cela inclut certaines propriétés de la multiplication,comme l'associativité ou la distributivité. Pour la définir correctement,commençons par définir la multiplication entre un polynôme et un monôme. L'idée est de multiplier tous les coefficients du polynôme par celui de monôme et d'ajouter à chaque indéterminée du polynôme l'exposant du monôme (selon les lois de distributions du corps).

(a * Xm) * (∑x=0nbkXk) =∑x=0n+m(a * bk) * Xk + m
(2 * X2) * (2 * X2- 3 X+4) =(4 * X2- 6 * X3+4 * X2)

Donc, multiplier deux polynômes revient à en décomposer un en monôme, effectuer tous les multiplications comme vue, et d'additionner tous les résultats obtenus.

(∑x=0makXk) * (∑x=0nbkXk) =∑x=0mak* ∑x=0n+m(a * bk) * Xk + m
(3 * X2+2) * (2 * X- 4) =(6 * X3- 12 * X2) +(4 * X- 8) =6 * X3- 12 * X2+4 * X- 8

Généralement,l'ensemble de tous les polynômes d'indéterminé "X" sur un anneau "A" est noté "A[X]". Si nous avons plusieurs indéterminés (comme "X" et "Y"),on note "K[X,Y]". De plus,les polynômes peuvent être munis d'une addition et d'une multiplication : l'ensemble des polynômes sur un anneau (unitaire) forme un nouvel anneau unitaire.

Les racines de polynômes

Une des caractéristiques des polynômes est l'ensemble de leurs racines. En fait,Une racine d'un polynôme est une valeur tel que, si on la substitue à l'indéterminée du polynôme, la valeur obtenue est "0". C'est un nombre qui "annule" le polynôme. Un exemple assez simple : prenons le polynôme à coefficients dans "Q" s'écrivant "X² +X - 2". Ce polynôme est très simple,suffisamment pour pouvoir en déduire de tête des racines "évidents" : "1" et "-2". Nous pouvons confirmer graphiquement ces résultats.

Nous pouvons ici effectuer une modification assez intéressante du polynôme. En effet,restons sur notre polynôme "X² +X - 2",et essayons de l'écrire sous la forme d'un produit de polynômes de degré inférieur. Déjà,quelque soit la forme avec laquelle nous écrirons ce polynôme, celui si s'annulera en "1" et en "-2". Donc,si on l'écrit sous la forme de produit de deux polynôme "Q" et "R",un des deux vaudra "0" en "1" et en "-2". Or,nous pouvons trouver deux polynômes s'annulant en "1" et en "-2" (qui sont par ailleurs les polynômes "les plus simples" s'annulant en ces valeurs) : le polynôme "X - 1" s'annule en "1",et "X +2" s'annule en "-2". Si nous multiplions ces deux polynômes,nous obtenons quelque chose de formidable : "X - 1" multiplié par "X + 2" donne "X² + X - 2", notre polynôme de départ.

(X - 1) * (X +2) =(X² +2 * X) +(-1 * X - 2) =X² +X - 2

Ce résultat peut être généralisé. En effet,un polynôme quelconque admettant une racine quelconque "r" peut s'écrire comme le produit de "X - r" et d'un autre polynôme. De manière équivalente,un polynôme quelconque admettant une racine quelconque "r" est divisible par "X - r". En plus,la réciproque est aussi vraie : un polynôme quelconque divisible par "X - r" admet une racine "r". La démonstration (présente ici) est assez simple et n'utilise que des propriétés basiques de la division de polynômes.

Selon l'appartenance ou la non-appartenance de racines de polynômes à coefficients dans un corps K dans ce même corps K, on peut en déduire certaines propriétés sur le corps.

Contenu

Les espaces vectoriels

Un type précis de structure

Qu'est ce qu'est un espace vectoriel ?

Grâce aux corps, nous pouvons définir une nouvelle structure algébrique particulièrement utile : l'espace vectoriel. Un espace vectoriel est une structure algébrique construire à partir d'un corps, sur un ensemble quelconque (qui n'est pas forcément celui du corps), tel qu'il contient une opération (généralement une forme d'addition) formant un groupe abélien sur l'espace vectoriel et qu'il existe une loi externe à gauche sur l'espace vectoriel avec les éléments du corps (qui doit être associative, admettre un neutre et distributive à gauche par rapport à la première loi de l'espace vectoriel). Bien que ce concept puisse sembler complexe, il est la base de choses très importantes et basiques en mathématiques. Prenons un corps "K" sur un ensemble "A", et un espace vectoriel "E" sur un ensemble "B".

K =(A,+,.)

Dans ce cas, l'espace vectoriel "E" admet une addition, tel que cette addition forme un groupe abélien sur "B".

(B,+)

En suite, il existe une loi externe à gauche entre un élément de "A" et un élément de "B" vers un élément de "B". Généralement, cette loi est notée comme une multiplication, avec généralement un "*".

∀a ∈A,∀b ∈B,∃c ∈B,a * b =c

Attention : il est impossible d'utiliser cette loi entre deux éléments de "B", seulement entre un élément de "A" et un élément de "B". Cependant, il est possible d'utiliser cette loi sur une opération entre des élements de "A" qui donnent un nouvel élément de "A", avec une opérations entre des éléments de "B", qui donnent un nouvel élément de "B". Cette propriété va nous être très utile pour les propriétés qui suivront. Déjà, cette loi est associative, ce qui veut dire qu'opérer deux éléments "a" et "c" de "A" avec la deuxième opération du corps puis utiliser cette opération avec un élément "b" de "B" est égal à opérer "c" et "b", puis "a" au résultat. Si l'on considère la deuxième opération du corps comme une multiplication et la loi externe de l'espace vectoriel comme une multiplication aussi, alors cela revient à dire que l'ordre de réalisation des multiplications n'importent pas.

∀a,c ∈A,∀b ∈B,(a * c) * b =a * (c * b)

La distributivité à gauche s'écrit comme dans un anneau, à la différence prés qu'il faut faire attention à l'ordre des opérandes pour respecter l'opération :

∀a ∈A,∀b,d ∈B,a * (b +d) =a * b +a * d

C'est la même chose pour la distributivité à droite.

∀a,c ∈A,∀b ∈B,(a +c) * b =a * b +c * b

Finalement, l'élément neutre du corps pour sa deuxième opération est aussi un élément neutre pour cette opération...

∀b ∈B,∃e ∈A,b * e =b

Si vous avez toutes ces conditions grâce à un corps "K", vous avec un espace vectoriel sur "K". L'exemple le plus simple d'espace vectoriel sur "K" est... "K". En effet, "K" est un espace vectoriel sur lui même. Comme "K" est un corps, sa première loi est bel et bien un groupe abélien, et sa deuxième loi se comporte comme une opération d'un élément de l'ensemble de "K" et... de l'ensemble de "K" (avec associativité, neutre et distributivité).

Plaçons nous dans le corps le plus simple pour définir des espaces vectoriels : "R". Déjà, comme nous l'avons vue, "R" est un espace vectoriel sur lui même. Or, il est possible de construire des ensembles de tous les "n-uplets" de "R", qui sont eux aussi des espaces vectoriels(généralement, nous noterons ces ensembles "R exposant n", comme avec un produit cartésien). Il faut cependant bien définir leurs propriétés. Déjà, nous allons définir une opération d'addition entre les "n-uplets", où la somme de deux "n-uplets" donne un nouveau "n-uplet" ou le k-ième élément du résultat représente la somme du k-ième élément du premier "n-uplet" et du k-ième élément du second "n-uplet". Comme cette opération se comporte comme plusieurs additions dans "R" disjointes, alors la structure de ces "n-uplets" et de cette opération ont les mêmes propriétés que dans "R" : un groupe abélien par cette addition.

∀(a,b,...,n),(a',b',...,n') ∈Rn,(a,b,...,n) +(a',b',...,n') =(a +a',b +b',...,n +n')

En suite, nous allons définir une opération entre ces "n-uplets" et "R", où l'on multiplie chaque élément du "n-uplet" par un élément de "R". Comme cette opération se comporte comme plusieurs multiplications dans "R" disjointes, alors la structure de ces "n-uplets" et de cette opération ont les mêmes propriétés que dans "R" : associativité, neutre (1) et distributivité.

∀(a,b,...,n) ∈Rn,∀x ∈R,x * (a,b,...,n) =(a * x,b * x,...,n * x)

Donc, "R exposant n" est un espace vectoriel sur "R". C'est d'ailleurs grâce à ce résultat que l'on peut démontrer que "R exposant 2" et "R exposant 3" sont des espaces vectoriels sur "R". Grâce à ce résultat, on peut lier géométrie et algèbre, puisque le plan 2D et l'espace 3D sont tout deux des espaces vectoriels. Ce résultat nous donne une façon précise de définir certains types précis de transformation géométrique, grâce à de l'algèbre.

Comme pour beaucoup de structures algébriques de ce genre, si il existe un "espace vectoriel", il existe la notion de "sous-espace vectoriel". Un sous-espace vectoriel est une structure algébrique construire à partir d'un espace vectoriel, sur un ensemble inclut dans l'espace vectoriel de départ, et où les éléments de cet ensemble sont stables par addition et par multiplication par un scalaire. Un exemple très simple : l'ensemble des vecteurs de la forme "(a, 0)" avec "a" un nombre réel quelconque de "R²" forme un sous-espace vectoriel de "R²". En effet, additionner deux éléments de ce genre "(b, 0)" et "(c, 0)" revient à calculer "(b + c, 0)" (qui appartient toujours à cet espace), et multiplier "(d, 0)" par un réel "e" revient à calculer "(e * d, 0)" (qui appartient toujours à cet espace). Graphiquement parlant, ce sous-espace vectoriel de "R²" représente... la droite des abscisses.

Avec ce concept, on peut en introduire un autre qu'il lui est directement lié : les vecteurs. Un vecteur est un élément quelconque d'un espace vectoriel. Par exemple, dans l'espace vectoriel formé par "R²" (comme défini plus haut), "(4, 8)" est un vecteur.

Les espaces vectoriels possèdent aussi des propriétés permettant de définir un type de formule précis : les combinaisons linéaires. Une combinaison linéaire est un type de formule possible dans un espace vectoriel sur un corps "K", représentant la somme de produits d'éléments de "K" et de vecteur de l'espace vectoriel. Le nom "linéaire" provient du fait qu'une combinaison linéaire est une somme de termes représentant des fonctions linéaires (un scalaire multiplié par un vecteur de l'espace). En fait, une combinaison linéaire dans un espace vectoriel représente une valeur qui est toujours dans l'espace vectoriel, puisque le produit d'éléments de "K" et de vecteurs donne un vecteur, et la somme de vecteurs donne un vecteur. Grâce à ça, on peut utiliser des indéterminées facilement dans un espace vectoriel, en représentant des éléments de "K" indéterminées, ou même des vecteurs indéterminées, permettant de résoudre des équations. Voici quelques exemples de combinaisons linéaires possibles, dans "R²".

4 * (7,8) +2 * (-4,1) =u ⇔u =(4 * 7 +2 * -4,4 * 8 +2 * 1) =(20,34)
-2 * (1,8) +-a * (1,4) =4 * (1,2) ⇔-2 * (1,8) +-4 * (1,2) =a * (1,4) ⇔(-2,-16) +(-4,-8) =a * (1,4) ⇔(-6,-24) =a * (1,4) ⇔a =-6
a0,a1,...,an∈R,w0,w1,...,wn∈Rm,v =∑x=0nakwk

Ici, toutes ces combinaisons donnent des résultats nets et précis. Or, il existe des équations formulables avec des équations linéaires ne possédant aucune solution dans "R²".

-2 * (1,6) +-a * (1,4) =4 * (1,2) ⇔-2 * (1,6) +-4 * (1,2) =a * (1,4) ⇔(-2,-12) +(-4,-8) =a * (1,4) ⇔(-6,-20) =a * (1,4) ⇔a * 1 =-6 ∧-4 * a =20 ⇔a =-6 ∧a =-5 ⇔⇔a ∈R2

Les combinaisons linéaires vont aussi nous permettre d'énumérer un fait très important. En effet, pour un vecteur donné, il est possible d'obtenir tout un ensemble de nouveau vecteur avec une combinaison linéaire de ce vecteur. Ici, si l'on nomme ce vecteur "u", alors toutes les combinaisons linéaires possibles avec ce vecteur sont de la forme "a * u", où "a" est un nombre réel quelconque. Par exemple, avec le vecteur "(1, 1)", vous pouvez formuler tous les vecteurs de la forme "a * (1, 1)", comme "(2, 2)", "(72, 72)", "(-0.1475, -0.1475)"...
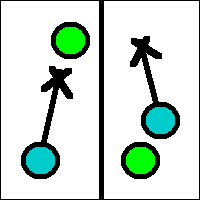
Nous pouvons faire la même chose avec tous les vecteurs possibles. Par exemple, prenons le vecteur "(1, 0)" : nous pouvons engendré "(3, 0)", "(pi, 0)" ou "(-0.000000000001, 0)". Ici, nous pouvons obtenir une combinaison linéaire de nos deux vecteurs d'exemple : "(1, 1)" et "(1, 0)". Nous obtenons donc une combinaison linéaire de la forme "a * (1, 1) + b * (1, 0)" avec "a" et "b" des nombres réels quelconques. Ici, on peut se poser une question : quel est l'ensemble précis des vecteurs calculables via cette combinaison linéaire? Quelques exemples peuvent s'obtenir en remplaçant "a" et "b" par des valeurs connues.

2 * (1,1) +1 * (1,0) =(3,2)
0.5 * (1,1) +10 * (1,0) =(10.5,0.5)

Prenons un exemple bien plus aléatoire : "(55, -44)". Ici, nous pouvons poser une équation qui devrait nous permettre de trouver une solution, si elle existe.

a * (1,1) +b * (1,0) =(55,-44) ⇔(a * 1 +b * 1,a * 1 +b * 0) =(55,-44)
⇔a +b =55 ∧a =-44 ⇔b =99 ∧a =-44 ⇔-44 * (1,1) +99 * (1,0) =(55,-44)

Vous pouvez prendre autant de valeurs que vous le voulez : vous trouverez toujours des valeurs fonctionnelles pour "a" et "b". Et donc, une question se pose : est ce que tout "R²" est obtensible avec une simple combinaison linéaire de "(1, 1)" et "(1, 0)"? Pour cela, considérons un vecteur "(x, y)" quelconque (faisant partie de "R²"), et voyons si, pour tout "x" et "y", nous pouvons trouver un "a" et un "b" fonctionnelle. Posons cela sous la forme d'une équation.

a * (1,1) +b * (1,0) =(x,y) ⇔(a * 1 +b * 1,a * 1 +b * 0) =(x,y)
⇔a +b =x ∧a =y ⇔b =x - y ∧a =x ⇔y * (1,1) +(x - y) * (1,0) =(x,y)

Or, ici, "y" est bel et bien un réel, et "x - y" aussi : tout "(x, y)" possède des "a" et "b" fonctionnelles, tout "(x, y)" de "R²" peut s'écrire comme une combinaison linéaire de "(1, 1)" et "(1, 0)". En procédant de manière similaire, on peut trouver plein de couples de vecteurs permettant aussi d'écrire tout "R²" : "(1, 1)" et "(1, 2)", "(1, 0)" et "(1, 1)", "(5, 100)" et "(5, 101)".... À l'inverse, nous pouvons trouver des couples de vecteurs, comme "(1, 0)" et "(-3, 0)", pour lesquelles l'ensemble des vecteurs obtensible par combinaison linéaire n'est pas "R²". Dans l'exemple pris ici, on démontre que l'ensemble des vecteurs obtenus ne représente pas "R²", car un élément de "R²" pris arbitrairement (bien qu'il y en ai une infinité possible) est absent de ces valeurs.

a * (1,0) +b * (-3,0) =(x,y) ⇔(a * 1 +b * -3,a * 0 +b * 0) =(x,y)
⇔a +-3 * b =x ∧y =0 ⇔(x,y) /=(1,1)

Dans tous les cas, nous formons un ensemble constitué d'une certaine quantité de vecteurs (ici 2), qui permettent d'obtenir des vecteurs possibles dans l'espace. Généralement, pour parler d'ensemble de vecteurs, on utilise le terme de famille, présenté au chapitre. Donc, nous définissons des ensembles de vecteurs, que nous nommons des familles de vecteurs, tel que leur combinaison linéaire puisse représenter des espaces quelconques.

Avec ces combinaisons linéaires, nous pouvons en déduire un théorème extrêmement important : l'ensemble des vecteurs calculables avec une combinaison linéaire d'un espace vectoriel quelconque avec une famille de vecteurs fixés et des coefficients "libres" dans le corps est un sous-espace vectoriel de cet espace vectoriel de départ. La démonstration de ce théorème est très simple, et est parfaitement algébrique. Déjà, rappelons la définition d'une combinaison linéaire (et rappelons que, algébriquement parlant, tout élément d'une combinaison linéaire appartient à l'espace vectoriel, validant la première condition disant que l'ensemble du sous-espace vectoriel doit être inclut dans l'ensemble de l'espace).

w0,w1,...,wn∈Rm,{a0,a1,...,an∈R,v =∑x=0nakwk}

Déjà, nous pouvons facilement prouver la stabilité par l'addition, en additionnant deux combinaisons de même famille de vecteurs entre elles.

∑x=0nakwk+∑x=0nbkwk=∑x=0n(ak+bk)wk=∑x=0nckwk∧c0,c1,...,cn∈R

Petit point important : ici, quand nous disons que les vecteurs sont fixés, nous voulons dire que, dans une opération de combinaisons linéaires, les vecteurs doivent rester les mêmes. Cependant, cela n'empêche pas que cela fonctionne pour toute famille de vecteur possible (comme nous l'avons quantifier au début de la démonstration), choisi au préalable. Finalement, on peut facilement prouver la stabilité par la multiplication par un scalaire.

b * ∑x=0nakwk=∑x=0n(b * ak)wk=∑x=0ndkwk∧d0,d1,...,dn∈R

Les deux stabilités demandées sont bel et bien respectées : tout ensemble formé des vecteurs calculables avec une combinaison linéaire dans un espace vectoriel donne un sous-espace vectoriel de ce même ensemble.

Avec ceci, nous pouvons introduire un concept primordial en algèbre linéaire : les sous-espaces vectoriels engendrés. Un sous-espace vectoriel engendré par une famille de vecteurs "A" est un sous-espace vectoriel dont les éléments ne représentent que des combinaisons linéaires des vecteurs de la famille "A". Une grande partie des théorèmes d'algèbre linéaire s'appuient entièrement sur ce concept. Généralement, pour une famille de vecteurs "f", le sous-espace vectoriel engendré par "f" est nommé "Vect(f)".

f =(u1,u2,...,un) ∈En
∀v ∈E,{v ∈Vect(f) ⇔∃(a1,a2,...,an) ∈Kn,v =a1* u1+a2* u2+... +an* un}

Intéressons nous à ce concept de famille de vecteur. Déjà, . Par exemple, la famille de vecteur de "R²" "{(1, 1), (3, 3)}" contient un vecteur que l'on peut obtenir par combinaison linéaires d'autres (ici, "3 * (1, 1) = (3, 3)"). Ce genre de famille a un nom : les familles liées. Une famille de vecteur est dite liée (ou linéairement dépendante) si l'un des vecteurs de la famille peut s'écrire comme combinaison linéaire non-nulle des autres vecteurs de la famille. Par définition, si une famille est liée à cause d'un vecteur "u", alors "u" appartient à l'espace vectoriel engendré par la famille de départ à laquelle on enlève "u". De même, tout multiple / combinaison linéaire de "u" appartient aussi à ce sous-espace vectoriel, et donc tout l'espace vectoriel engendré par "u" est aussi dans cet espace vectoriel. Pour une famille liée "f", voici la formalisation mathématique du concept (où "g" est la famille où "u" est exclu).

f =(u1,u2,...,un) ∈En
∃m ∈{1,2,...,n},g =f \ {um},g ={w1,w2,...,wn - 1} ∈En - 1
∃(a1,a2,...,an - 1) ∈Kn - 1,um=a1* w1+a2* u2+... +an - 1* wn - 1

À l'inverse, une famille de vecteur est dite libre (ou linéairement indépendante) si aucun vecteur de la famille ne peut s'écrire comme combinaison linéaire non-nulle des autres vecteurs de la famille. Donc, on peut en déduire que le sous-espace vectoriel engendré par une famille de vecteur liée à cause d'un vecteur quelconque est égal à celui engendré par la famille de vecteur sans ce vecteur "u".

Vect(f) =Vect(g)

Le type de famille de vecteur le plus utile est probablement la famille génératrice. Une famille de vecteur est dite génératrice si son sous-espace vectoriel engendré est l'entièreté de l'espace vectoriel de départ. Comme nous l'avons vue plus haut, c'est le cas de notre famille "{(1, 1), (1, 0)}" dans "R²". Il est possible de compléter ce concept, pour en obtenir un nouveau très pratique : une base d'un espace vectoriel. Une base d'un espace vectoriel est une famille libre et génératrice de cet espace vectoriel. Il s'agit de la donnée minimum nécessaire dans un espace vectoriel pour obtenir la valeur de chaque vecteur possible. Il existe d'ailleurs autant de base qu'il existe de famille de vecteur libre et génératrice.

f =(u1,u2,...,un) ∈En
∀v ∈E,∃(a1,a2,...,an) ∈Kn,v =a1* u1+a2* u2+... +an* un

Avec les bases, on peut définir un des concepts les plus importants des espaces vectoriels : la dimension. La dimension d'un espace vectoriel (aussi nommée dimension de Hamel) est le cardinal commun de toutes ses bases. En effet, toutes les bases d'un espace vectoriel quelconque ont le même cardinal (la même taille). En réalité, ce résultat n'est pas si facile à démontrer : il demande l'utilisation d'un lemme, nommé lemme de Steinitz (démontré ici), qui permet d'en déduire ce théorème (démontré ici).

f =(u1,u2,...,un) ∈En
g =(v1,v2,...,vm) ∈En
Vect(f) =Vect(g) =E ⇔n =m

Ici, bien que nous considérons "E" entier, une conséquence de ce théorème stipule que si "f" et "g" sont deux familles libres qui ne génèrent pas "E" entier, mais un sous-espace vectoriel "F" de "E" (et qu'elles génèrent le même, bien évidément), alors "m = n". Pareil, ce théorème s'obtient en restreignant "E" au sous-espace vectoriel engendré : "f" et "g" en sont deux bases, et ont donc le même cardinal. Cependant, dans ce cas, la réciproque est fausse, on peut trouver des familles "f" et "g" de même dimensions qui ne génère pas le même sous-espace vectoriel de "E". De manière parfaitement logique, cela s'explique par le fait que passer à un sous-espace vectoriel requiert une implication dans le raisonnement ("F est un sous-espace vectoriel" implique que "toute base de "F ont le même cardinal", mais la réciproque de cette proposition ne veut rien dire), cassant l'équivalence (puisque l'on part d'un plus gros espace vectoriel, demandant de passer à un autre : le sous-espace vectoriel).

Vect(f) =Vect(g) =F ⇒n =m

Avec cela, nous allons "déterrer" un concept géométrique que nous avons traité au chapitre 3 : les coordonnées. En effet, en algèbre linéaire, les coordonnées d'un vecteur quelconque dans une base quelconque représentent les valeurs des scalaires à multiplier à chaque élément de la base pour obtenir le vecteur recherché. En d'autres termes, il s'agit des scalaires dans la combinaisons linéaire permettant de former le vecteur de départ via cette base. Ici, les coordonnées dépendent évidemment du vecteur, mais aussi de la base choisie. Généralement, les coordonnées d'un vecteur "v" dans une base "b" se note "v indice b". Prenons un exemple simple dans "R2" : une base "B" représentant la base canonique, et la base "C" représentant une autre base.

B ={(1,0),(0,1)},C ={(1,1),(0,1)}

Déjà, exprimer un vecteur avec des coordonnées donnée dans une base est extrêmement simple, puisque cela ne demande qu'une simple combinaison linéaire. Par exemple, trouvons les vecteurs de coordonnées "(4, 3)" dans la base "B" et "(5, 1)" dans la base "C".

v1=4 * (1,0) +3 * (0,1) =(4,3)
v2=5 * (1,1) +1 * (0,1) =(5,6)

Faisons l'opération inverse : trouver les coordonnées associées à un vecteur donné dans une certaine base. Il est très facile de trouver les coordonnées des vecteurs "(1, 0)" et "(1, 1)" dans la base canonique : il s'agit de "(1, 0)" et "(1, 1)".

(1, 0)B=(1, 0),(1, 1)B=(1, 1)

Ici, le défi est de trouver les expressions des vecteurs "(1, 0)" et "(1, 1)" dans la base "C". La meilleure façon est de résoudre un petit système, permettant de trouver les valeurs des scalaires. C'est généralement de cette façon que nous fairons pour passer des coordonnées d'une base à une autre facilement.

(1,0) =a1* (1,1) +a2* (0,1) ⇔1 =a1* 1 +a2* 0 ∧0 =a1* 1 +a2* 1 ⇔a1=1 ∧a2=-1
(1,1) =a1* (1,1) +a2* (1,0) ⇔a1=1 ∧a2=0

Donc, nous avons trouver les scalaires permettant de former ce vecteur dans la base "C" : il s'agit de ses coordonnées dans cette même base.

(1, 0)C=(1, -1),(1, 1)C=(0, 1)

Si nous voulons formuler ces systèmes de manière plus précise, pour un vecteur "v" exprimé dans une base "b" :

v =∑k=1nakbk

Ou, avec chaque élément de "v" un à un :

v1=∑k=1nak(bk)1
v2=∑k=1nak(bk)2
vi=∑k=1nak(bk)i

Un (autre) exemple dans "R2" est présent juste ici. Cependant, notre exemple pose problème : dans "R²", un vecteur s'écrit "(a, b)", et des coordonnées dans une base s'écrivent "(x, y)" : de la même façon. C'est pour cela qu'il faut toujours préciser avec quel type d'objet on travaille : vecteur ou coordonnées. Dans ce cas, cela peut sembler un peu inutile, puisque les simples vecteurs de "R²" sont suffisants. Or, dans le cas d'espaces vectoriels bien plus complexes, utiliser des coordonnées peut s'avérer obligatoire dans beaucoup de cas, ce qui explique leur importance.

Ici, on sait que des coordonnées dans un espace de dimension quelconque (pas forcément fini) "d" représentent donc "d" scalaires (un nombre fini, voir une infinité). Donc, l'ensemble des coordonnées possibles dans une base d'un espace vectoriel sur un corps "K" de dimension "n" représentent le produit cartésien de "K", "d" fois. De plus, on peut en déduire que l'ensemble des coordonnées dans une base forme un espace vectoriel sur "K" lui aussi. Dans le cas où "d" est fini, la démonstration est immédiate : la somme des coordonnées de deux vecteurs donne les coordonnées du vecteur représentant la somme des vecteurs (stabilité de la somme), et multiplier les coordonnées par un scalaire donne les coordonnées du vecteur multiplié par ce même scalaire.

Il existe d'ailleurs une opération possible avec des sous-espaces vectoriels : la somme directe. Cet opération est inspirée de la somme des semi-groupes (qui est d'ailleurs possible ici, puisque les espaces vectoriels sont aussi des semi-groupes). La somme de deux sous-espace vectoriel "A" et "B" d'un espace vectoriel "E" est dite directe si, pour tout vecteur dans la somme, il n'existe qu'un seul et unique couple de vecteurs "(u, v)" de "A" et "B" tel que ce vecteur est la somme de "u" et "v". En d'autres termes, la somme est dite directe si (et seulement si) tout vecteur de la somme ne peut se décomposer qu'une fois dans les deux sous-espaces vectoriels. Un exemple où ceci n'est pas vrai est (dans "R²") la somme du sous-espace vectoriel engendré par le vecteur "(1, 0)" et de... lui même. En effet, un des vecteurs présent dans la somme est "(1, 0)", qui représente "(0.5, 0) + (0.5, 0)". Or, ce vecteur a plein de décompositions possibles : "(1, 0) + (0, 0)", "(0, 0) + (1, 0)", "(0.4, 0) + (0.6, 0)"...

(0.5,0) +(0.5,0) =(1,0) +(0,0) =(0,0) +(1,0) =(0.4,0) +(0.6,0)

Cependant, la somme des sous-espaces vectoriels engendré par "(1, 0)" et "(0, 1)" est belle et bien directe. En fait, pour qu'une somme de sous-espaces vectoriels soit directe, il faut que la juxtaposition d'une base du premier et du deuxième soit une famille libre. Cela est assez simple à comprendre : si la juxtaposition d'une base du premier et du deuxième est une famille libre, alors toute expression de vecteur dans cette famille (ou dans toute famille générant le même espace vectoriel) est unique. Comme le couple que nous voulons être unique représente une expression du vecteur nécessaire dans notre famille (ou dans n'importe quelle famille générant cet espace vectoriel), il est aussi unique. La réciproque est aussi vraie (si la juxtaposition d'une base du premier et du deuxième est une famille libre), la somme des deux sous-espaces vectoriels est directe.

(x,y) =(a,0) +(0,c) ⇒x =a ∧y =c
(7,4) =(7,0) +(0,4)

Un exemple assez bizarre d'espace vectoriel est l'espace fonctionnel. Pour rappel, un espace fonctionnel est un ensemble d'applications (et donc, de fonctions) entre deux ensembles X et Y. Avec cette simple définition, un espace fonctionnel n'est pas obligatoirement un espace vectoriel. Or, si l'ensemble d'arrivée représente un espace vectoriel "F" sur un corps "K", l'espace fonctionnel est lui aussi un espace vectoriel sur "K". Pour cela, nous devons munir cet espace de lois assez similaires aux lois de "F" :

f : X ⟶F,x ⟶f(x)
g : X ⟶F,x ⟶g(x)
(f +g)(x) =f(x) +g(x)
∀a ∈F,(a * f)(x) =a * f(x)

Dans tous les cas, on remarque que l'espace d'arrivée des fonctions obtenues par somme et par multiplication par un scalaire est "F", et donc que ces applications représentent de nouvelles applications allant de "X" vers "F". Donc, on constate la stabilité de cet ensemble par l'addition et la multiplication par un scalaire (elle sont elles aussi des applications allant de "X" vers "F"). De plus, on constate aussi que cet ensemble a les mêmes propriétés que l'espace d'arrivée (et donc, cet ensemble a les mêmes propriétés qu'un espace vectoriel). Donc, il s'agit bel et bien d'un espace vectoriel.

Les espaces vectoriels quotients

Comme il existe des groupes et des anneaux quotients, il existe aussi des espaces vectoriels quotients. Un espace vectoriel quotient d'un espace vectoriel "E" par un sous-espace vectoriel "F" est un espace vectoriel sur l'ensemble quotient de "E" par une relation définie à partir de "F". Ici, nous devons définir rigoureusement la relation d'équivalence permettant de définir cet ensemble quotient. En fait, deux éléments "u" et "v" sont en relations si "u - v" appartient à "F" (avec ici, "-" étant le symbole de l'inverse de la première loi de l'espace, quelle qu'elle soit).

∀u,v ∈E,u ~ v ⇔u - v ∈F

Ici, nous devons prouver que cette relation est bel et bien une relation d'équivalence (en prouvant quelle est réflexive, symétrique et transitive). Pour la réflexivité, c'est immédiat : "u - u = 0" avec "0" étant le neutre de la première loi de "E", qui appartient donc à "F" (puisque "F" est un sous-espace vectoriel de "E"), ce qui prouve que "u" est en relation avec lui-même. Pour la symétrie, c'est très simple : permuter l'ordre de "u" et "v" revient à obtenir "v - u", qui est égal à "-(u - v)", qui est bel est bien dans "F", puisqu'il est stable par inversion de la première loi. Pour la transitivité, si "u - v" appartient à "F", et "v - w" appartient aussi à "F", cela implique que "(u - v) + (v - w)" appartient à "F" (avec ici, "+" étant le symbole de la première loi de l'espace, quelle qu'elle soit), et "(u - v) + (v - w) = (u - w)", qui appartient à "F", prouvant que "u" et "w" sont en relation aussi.

∀u,v ∈E,u ~ v ⇔u - v ∈F ⇔-(v - u) ∈F ⇔v - u ∈F ⇔v ~ u
∀u,v,w ∈E,u ~ v ∧v ~ w ⇔u - v ∈F ∧v - w ∈F ⇒(u - v) +(v - w) =u - w ∈F ⇔u ~ w

Maintenant, démontrons que "E/~" a une structure d'espace vectoriel sur "K" (ce qui sera très simple). Déjà, définissons la première loi de cette espace comme ceci, avec "+" étant la première loi de "E" :

∀a,b ∈E/~,∃c,d ∈E,a ∈[c] ∧b ∈[d]
a ~ b =[c +d]

Ici, "c + d" est (par stabilité de "E" par sa première loi) un élément de "E" : "[c + d]" est donc bel et bien un élément de "E/~". Maintenant, définissons la deuxième :

∀a ∈E/~,∃c ∈E,a ∈[c]
∀e ∈K,e * a =[e * c]

Ici, "e * c" est (par stabilité de "K" et "E" par sa deuxième loi) un élément de "E" : "[e * c]" est donc bel et bien un élément de "E/~". Les deux lois marchent correctement : "E/~" est un espace vectoriel sur "K". Généralement, cette espace vectoriel est plutôt noté "E/F".

E/~ =E/F

Les systèmes linéaires

Avant de traiter des systèmes linéaires, parlons des équations linéaires. Une équation linéaire est une équation où l'on cherche la valeur d'une inconnue dans un espace vectoriel, où nous savons que cette inconnue multiplié par un scalaire non-nul donne une autre valeur de l'espace vectoriel. Par exemple, une équation linéaire dans un l'espace vectoriel "R²" sur "R" peut être :

8 * (a,b) =(5,-6)

Résoudre ce genre d'équation est très facile :

k * (a,b) =(c,d) ⇔(a,b) =(ck,dk)

Avec ça, nous allons pouvoir parler des systèmes linéaires. En fait, un système linéaire est un système d'équations composé d'équations linéaires. Par exemple, ceci peut être un système linéaire, dans un espace vectoriel sur "R" :

3 * u +4 * v =2
8 * u - 7 * v =5

La façon la plus simple de résoudre ce genre d'équation reste la substitution.

3 * u +4 * v =2
8 * u - 7 * v =5
⇔
8 * u =7 * v +5
3 * 7 * v + 58+4 * v =2
⇔
53 * v + 158=2
8 * u =7 * v +5
⇔
v =153
8 * u =7 * 153+5
⇔
v =153
u =3453

Les applications linéaires

Les applications linéaires sont un objet élémentaire dans l'étude des espaces vectoriels. De manière un peu complexe, une application linéaire est un morphisme d'espace vectoriel sur un même corps "K". Il s'agit d'ici de la façon complexe de définir ce concept. En effet, une application linéaire est une application mathématique allant d'un espace vectoriel vers un autre (tous deux sur un corps "K"), tout en gardant une certaine "similarité" dans la façon dont l'application transforme des objets avant / après opération. Nous allons expliciter cette "similarité" dés maintenant. Déjà, utiliser une application linéaire sur un vecteur "a + b" (avec "a" et "b" des vecteurs du premier espace vectoriel et "+" est la première loi du premier espace vectoriel) revient à appliquer la première loi du deuxième espace vectoriel entre l'image de "a" puis de "b" par cette même application linéaire. Donc, on peut "prédire" le résultat d'une opération dans le deuxième espace vectoriel grâce au premier espace vectoriel et une application linéaire. Dans le cas d'une application linéaire "f" allant d'un espace vectoriel "E" vers un espace vectoriel "F" sur un corps "K", on note :

∀a,b ∈E,f(a +b) =f(a) +f(b)

Deuxièmement, utiliser une application linéaire sur un vecteur "c * a" (avec "a" un vecteur du premier espace vectoriel, "c" un scalaire provenant de "K" et "*" est la deuxième loi du premier espace vectoriel) revient à appliquer la deuxième loi du deuxième espace vectoriel entre "c" et l'image de "a" par cette même application linéaire. Encore une fois, on peut "prédire" le résultat d'une opération dans le deuxième espace vectoriel grâce au premier espace vectoriel et une application linéaire.

∀c ∈K,∀a ∈E,f(c * a) =c * f(a)

Finalement, l'élément neutre du premier espace doit toujours avoir comme image l'élément neutre du deuxième espace par une application linéaire. Dire qu'une application entre deux espaces vectoriels respecte ces trois propriétés équivaut à dire que l'application est linéaire. Cette propriété permet deux réunir les deux premières propriétés en une seule équivalente :

f(k * a +b) =k * f(a) +f(b)

La démonstration de son équivalence est très simple :

f(a +b) =f(a) +f(b) ∧f(k * a) =k * f(a) ⇒f(k * a +b) =f(k * a) +f(b) =k * f(a) +f(b)
f(k * a +b) =k * f(a) +f(b) ⇒f(k * a +0) =k * f(a) +f(0) ⇒f(k * a) =k * f(a)
f(k * a +b) =k * f(a) +f(b) ⇒f(1 * a +b) =1 * f(a) +f(b) ⇒f(a +b) =f(a) +f(b)

Comme pour tout morphisme, il existe des applications linéaires qui sont des endomorphismes (dit linéaires), des isomorphismes (toujours linéaires) et des automorphismes (encore... linéaires).

Comme pour tout morphisme, la composition de deux applications linéaire forme une nouvelle application linéaire. La démonstration s'obtient très facilement avec quelques calculs.

h(a +b) =f(g(a +b)) =f(g(a) +g(b)) =f(g(a)) +f(g(b)) =h(a) +h(b)
h(k * a) =f(g(k * a)) =f(k * g(a)) =k * f(g(a)) =k * h(a)

Prenons un exemple très simple : l'application allant de "R²" vers "R²", en transformant "(x, y)" en "(2 * x, 2 * y)". Cette application est parfaitement linéaire, et on peut facilement le démontrer. Déjà, la première propriété est respectée, et l'on peut le vérifier de manière algébrique.

∀a,b ∈R2,∃x,x',y,y' ∈R,a =(x,y),b =(x',y'),f(a +b) =f(x +x',y +y') =2 * (x +x',y +y') =2 * (x,y) +2 * (x',y') =f(a) +f(b)

La deuxième propriété est aussi vraie, et ce n'est pas si difficile que ça à démontrer non plus.

∀a,b ∈R2,∃x,y,c ∈R,a =(x,y),f(c * a) =f(c * x,c * y) =2 * (c * x,c * y) =c * 2 * (x,y) =c * f(a)

Finalement,"f(0,0) =(0,0)",donc cette application est belle est bien linéaire. On peut même généraliser ce résultat. Effectivement,on peut facilement montrer que toutes applications transformant "(x, y)" en "(w * x, z * y)" avec "w" et "z" des scalaires quelconques est linéaire. Ce résultat est démontré ici,et est très similaire à la démonstration que nous venons juste de voir.

Un résultat intéressant avec les applications linéaires concerne les bases d'espaces vectoriels. En effet,l'image d'une base de l'espace vectoriel de départ par une application linéaire représente une famille de vecteurs qui engendre l'image de l'application dans l'espace vectoriel d'arrivé. La démonstration de ce théorème (présente ici) utilise les résultats basiques de linéarité.

Pour rester sur les bases,nous pouvons obtenir un résultat assez pratique : tout calcul avec une application linéaire peut entièrement être substitué par le résultat de cette application avec des vecteurs d'une base. En effet,considérons une application linéaire "f" allent d'un espace vectoriel "E" sur un corps "K" vers un espace vectoriel "F" toujours sur "K",et considérons une base de "E" noté "B",dont tous les éléments sont notés "b indice i" avec "i" étant entre "1" et la dimension de "E". Tout vecteur de "E" peut donc s'écrire avec une combinaison linéaire de vecteur de "B",dont les éléments nécessaires pour obtenir le vecteur représentent les coordonnées du vecteur dans "B" (comme vu plus haut). Ici,on peut utiliser les propriétés des applications linéaires pour voir que toute image de cette application linéaire peut se calculer avec seulement les images des vecteurs de "B".

f : E ⟶F
∀u ∈E,∃(x1,x2,...) ∈KDim(E),u =∑k=1Dim(E)xkbk
f(u) =f(∑k=1Dim(E)xkbk) =∑k=1Dim(E)f(xkbk) =∑k=1Dim(E)xkf(bk)

Un exemple particulièrement pratique d'application linéaire concerne les coordonnées. En effet,l'application allant d'un espace vectoriel quelconque de dimension finie "n" à l'espace des coordonnées dans une base de cet espace vectoriel est un isomorphisme linéaire. L'expression de cette application est assez simple :

∀a ∈E,f(a) =f(∑k=1nakek) =(a1,a2,...,an)

La démonstration de sa linéarité est elle aussi assez simple :

f(a +b) =f(∑k=1nakek+∑k=1nbkek) =(a1+b1,a2+b2,...,an+bn) =(a1,a2,...,an) +(b1,b2,...,bn) =f(a) +f(b)
f(q * a) =f(q * ∑k=1nakek) =(q * a1,q * a2,...,q * an) =q * (a1,a2,...,an)

Pour prouver l'isomorphisme, on a juste à trouver l'application réciproque (qui est très simple à trouver).

g : Kn⟶E,a ⟶∑k=1nakek
a =(a1,a2,...,an),f(g(a)) =f(∑k=1nakek) =a

Avec ça,on peut prouver quelque chose de très pratique : tout espace vectoriel de dimension finie "n" sur un corps "K" est isomorphe à "K exposant n". Donc,tout espace vectoriel a les mêmes propriétés que "R exposant n".

Ici,l'ensemble des morphismes allant de "E" vers "F" est noté "L(E, F)", et est un sous-ensemble de l'ensemble des applications allant de "E" vers "F". Ils ont donc les exacts mêmes lois de compositions que cet espace vectoriel d'applications.

∀f,g ∈L(E,F)
(f +g)(x) =f(x) +g(x) ∧∀a ∈F,(a * f)(x) =a * f(x)

En utilisant les propriétés des applications linéaires,on peut cependant améliorer ces opérations, et démontrer que "L(E, F)" est un sous-espace vectoriel de l'ensemble des applications allant de "E" vers "F". Déjà,on sait que l'identité est dans cette ensemble. De plus,démontrons que "(f +g)" est linéaire,et que "(a * f)" aussi,et donc que l'ensemble des applications linéaires est bel et bien un sous-espace vectoriel de l'ensemble des applications allant de "E" vers "F".

(f +g)(x +y) =f(x +y) +g(x +y) =f(x) +f(y) +g(x) +g(y) =f(x) +g(x) +f(y) +g(y) =(f +g)(x) +(f +g)(y)
(f +g)(b * x) =f(b * x) +g(b * x) =b * f(x) +b * g(x) =b * (f +g)(x)
(a * f)(b * x) =a * f(b * x) =a * b * f(x) =b * a * f(x) =b * (a * f)(x)
(a * f)(x +y) =a * f(x +y) =a * f(x) +a * f(y) =(a * f)(x) +(a * f)(y)

Il existe un résultat similaire avec les isomorphismes. En effet,la composition d'isomorphismes donne un nouvel isomorphisme. La démonstration est immédiate : la composition de deux morphismes donne un morphisme,et la composition de deux bijections donne une bijection (et,pour rappel,dire qu'une application est un isomorphisme linéaire revient à dire qu'elle est un morphisme bijectif). Donc,la composition d'isomorphisme linéaire est bel et bien un isomorphisme linéaire.

∀f,g ∈Isom(E,F),f ∘g ∈Isom(E,F)

Un type d'application linéaire un peu spécial est la forme linéaire. Une forme linéaire (aussi nommée covecteur) est une application allant d'un espace vectoriel sur un corps "K" vers... le corps "K" lui même. Elle doit cependant respecter une propriété précise : elle doit être linéaire sur l'espace vectoriel trivial de "K".

f : E ⟶K,v ⟶f(v)
f(v +u) =f(v) +f(u) ∧f(k * v) =k * f(v)

Ici,un exemple de forme linéaire est la somme de tous les éléments des coordonnées dans une base fixe de vecteurs de l'espace de départ. Il est assez facile de le démontrer. Pour un vecteur "u" où les coefficients de ces coordonnées s'écrivent "u indice n",et où les "b indice n" représentent les éléments de la base :

f : E ⟶K,u ⟶∑k=1nun
f(u +v) =∑k=1n(un+vn) =∑k=1nun+∑k=1nvn=f(u) +f(v)
f(a * u) =∑k=1n(a * un) =f(u) =a * ∑k=1nun=a * f(u)

Il existe d'ailleurs un espace spécial engendré par les formes linéaires : l'espace dual. L'espace dual d'un espace vectoriel est l'ensemble de toutes les formes linéaires sur cet espace. Généralement,pour un espace vectoriel "E", sont espace dual est noté "E*" (à ne pas confondre avec "E" privé de 0).

E*

D'ailleurs,cet espace représente l'espace des applications linéaires allant de "E" vers "K" (noté "L(E, K)"), qui est donc un espace vectoriel. Les formes linéaires s'opérent donc exactement comme les éléments de "L(E,K)".

∀f,g ∈E*
(f +g)(x) =f(x) +g(x)
∀a ∈K,(a * f)(x) =a * f(x)

Ce concept va nous permettre dans introduire un autre : la base duale. La base duale d'un espace dual (d'un espace vectoriel sur un corps "K") est une base de l'espace dual. Pour comprendre pourquoi cette base existe,posons un calcul simple,avec "b" une base de l'espace vectoriel de départ.

f(u) =f(∑k=1nunbn) =∑k=1nunf(bn)

Ici,nous voyons donc une combinaison linéaire, dont on voudrait trouver une base. En regardant,on pourrait avoir envie de considérer que "f(b indice n)" ou "u indice n" est une base. Or cela ne ferait pas sens : on est dans un espace où les objets que l'on veut combiner sont des applications,elle ne peut donc pas être "u indice n" qui est un scalaire. De plus,elle ne peut pas être "f(b indice n)" non plus,car "f(b indice n)" est ici fixé,et est donc aussi un scalaire. Or,on peut trouver une application qui fait l'affaire,et qui prendra la place de "u indice n". Donc,nous allons définir une application (généralement noté "e* indice n") qui, à "u", associe sa coordonnée "n-ième" dans la base "b" (et donc, qui associe "u indice n" à "u"). Ici,la base formée de tous les "e* indice n" nécessaire est la base duale de l'espace. Dans ce cas,on peut écrire :

f(u) =∑k=1nen(u) * f(bn)

Les applications multilinéaires

Comme il existe,pour des applications à une variable,des applications "linéaires",il existe aussi une forme de linéarité pour des applications à plusieurs variables. Commençons par la forme la plus simple (et la plus utilie) : les applications bilinéaires. Une application bilinéaire est une application prenant deux vecteurs de deux espaces vectoriels "E" et "F" (généralement les mêmes, mais ce n'est pas obligatoire), et allant vers un autre espace vectoriel "G" (et donc, allant de "E X F" vers "G"), de telle manière qu'elle soit linéaire en ses deux variables. Ici,les propriétés que l'application doit respecter s'énoncent ainsi :

f : E X F ⟶G,(x,y) ⟶z
f(x +x',y) =f(x,y) +f(x',y)
f(x,y +y') =f(x,y) +f(x,y')
f(a * x,y) =f(x,a * y) =a * f(x,y)

Essayons de bien comprendre ces propriétés. En fait, quand on dit "linéaire en chacune de ces variables", cela doit se comprendre d'une manière très pratique : si l'on considère la deuxième variable constante, alors l'application doit être linéaire (comme vue plus haut) avec la première variable (et vice-versa pour la deuxième variable). On peut définir deux nouvelles applications ne prenant qu'une variable à partir de cette application, justement en considérant l'autre variable constante, et vérifier leur linéarité.

g(x) =f(x,C)
g(x +x') =f(x +x',c) =f(x,c) +f(x',c) =g(x) +g(x')
g(a * x) =f(a * x,c) =a * f(x,c) =a * g(x)
h(y) =f(c,y)
h(y +y') =f(x,y +y') =f(x,y) +f(x,y') =h(y) +h(y')
h(a * y) =f(c,a * y) =a * f(c,y) =a * h(x)

Ici, dans la dernière ligne, en renommant "c" en "x" et "y" en "c", on obtient la ligne juste avant la définition de "h", ce qui permet de justifier en plus de tout ça pourquoi :

f(a * x,y) =f(x,a * y) =a * f(x,y)

D'ailleurs, on peut aussi raccourcir ces trois propriétés nécessaires en faisant un raccourci similaire que celui que nous avons vue plus haut :

f : E X F ⟶G,(x,y) ⟶z
f(a * x +b * x',y) =a * f(x,y) +b * f(x',y)
f(x,c * y +d * y') =c * f(x,y) +d * f(x,y')

L'équivalence entre ces deux façon de faire est elle aussi très simple à démontrer :

f : E X F ⟶G,(x,y) ⟶z
f(x +x',y) =f(x,y) +f(x',y) ∧f(a * x,y) =a * f(x,y) ⇒f(a * x +b * x',y) =f(a * x,y) +f(b * x',y) =a * f(x,y) +b * f(x',y)
f(a * x +b * x',y) =a * f(x,y) +b * f(x',y) ⇒f(x +x',y) =f(1 * x +1 * x',y) =f(x,y) +f(x',y) ∧f(a * x +0 * x',y) =a * f(x,y) +0 * f(x',y) =a * f(x,y)
f(x,y +y') =f(x,y) +f(x,y') ∧f(x,c * y) =c * f(x,y) ⇒f(x,c * y +d * y') =f(x,c * y) +f(x,d * y') =c * f(x,y) +d * f(x,y')
f(x,c * y +d * y') =c * f(x,y) +d * f(x,y') ⇒f(x,y +y') =f(x,1 * y +1 * y') =f(x,y) +f(x,y') ∧f(x,c * y +0 * y') =c * f(x,y) +0 * f(x,y') =c * f(x,y)
f(e * x,y) =e * f(x,y) ∧f(x,e * y) =e * f(x,y) ⇔f(e * x,y) =f(x,e * y) =e * f(x,y)

Prenons un exemple, avec une application précise :

f : R² X R² ⟶R²,(x,y) X (w,z) ⟶(x * w - y * z,x * z +w * y)

Cette application respecte toutes les propriétés nécessaires (bien que les calculs soient particulièrement longs et ennuyants à faire).

f((x,y) +(x',y'),(w,z)) =((x +x') * w - (y +y') * z,(x +x') * z +w * (y +y')) =(x * w +x' * w - (y * z +y' * z),(x * z +x' * z) +(w * y +w * y'))
f((x,y) +(x',y'),(w,z)) =(x * w - y * z +x' * w - y' * z,x * z +w * y +x' * z +w * y') =(x * w - y * z,x * z +w * y) +(x' * w - y' * z,x' * z +w * y') =f((x,y),(w,z)) +f((x',y'),(w,z))
f((x,y),(w,z) +(w',z')) =(x * (w +w') - y * (z +z'),x * (z +z') +(w +w') * y) =(x * w +x * w' - (y * z +y * z'),(x * z +x * z') +(w * y +w' * y))
f((x,y),(w,z) +(w',z')) =(x * w - y * z +x * w' - y * z',x * z +w * y +x * z' +w' * y) =(x * w - y * z,x * z +w * y) +(x * w' - y * z',x * z' +w' * y) =f((x,y),(w,z)) +f((x,y),(w',z'))
f(a * (x,y),(w,z)) =(a * x * w - a * y * z,a * x * z +w * a * y) =(x * a * w - y * a * z,x * a * z +a * w * y) =f((x,y),a * (w,z))
f(a * (x,y),(w,z)) =(a * x * w - a * y * z,a * x * z +w * a * y) =(a * (x * w - y * z),a * (x * z +w * y)) =a * (x * w - y * z,x * z +w * y) =a * f((x,y),(w,z))

Un peu plus tôt,nous avons vu qu'il est possible d'obtenir toutes les images d'une application linéaire avec seulement les images des éléments d'une base : c'est la même chose dans le cas d'une application bilinéaire. Cependant,le résultat est un peu plus complexe à obtenir,mais l'idée reste la même : sortir chaque valeur petit à petit du calcul,pour obtenir un ensemble de sommes / produits de valeur,où l'application n'est appelé que pour les vecteurs de la bases.

f : E X F ⟶G
∀u ∈E,∃(x1,x2,...) ∈KDim(E),u =∑k=1Dim(E)xkbk
∀v ∈F,∃(y1,y2,...) ∈KDim(F),v =∑k=1Dim(F)ykck
f(u,v) =f(∑k=1Dim(E)xkbk,∑l=1Dim(F)ylcl) =∑k=1Dim(E)f(xkbk,∑l=1Dim(F)ylcl) =∑k=1Dim(E)∑l=1Dim(F)f(xkbk,ylcl) =∑k=1Dim(E)∑l=1Dim(F)xkylf(bk,cl)

Cette formule pose un problème : il existe "Dim(E) * Dim(F)" valeurs possibles pour "f(b indice k,c indice l)". Donc,la praticité de cette formule dépend grandement du contexte. Cependant,le sens derrière cette formule la rend quand même assez importante : le connaissance des images de toutes les permutations d'éléments des 2 bases possibles suffit à obtenir toutes les images par cette application.

Comme il existe des formes linéaires,il existe aussi des formes bilinéaires. Une forme bilinéaire est une application allant de l'ensemble des couples entre deux espaces vectoriels (pas forcément les mêmes) sur un corps "K" vers le corps "K" lui même. Si les deux espaces vectoriels sont le même (que l'on va noter "E"),on parle de forme bilinéaire sur "E". Elle doit cependant respecter une autre propriété précise : elle doit être bilinéaire sur l'espace vectoriel trivial de "K".

f(x +x',y) =f(x,y) +f(x',y)
f(x,y +y') =f(x,y) +f(x,y')
f(a * x,y) =f(x,a * y) =a * f(x,y)

Avec cela,nous pouvons définir le concept d'orthogonalité. Deux vecteurs de deux espaces vectoriels sur un même corps sont dit orthogonaux par une forme bilinéaire si la valeur de ces deux vecteurs par cette forme bilinéaire vaut le nul multiplicatif du corps de départ. Il existe donc une orthogonalité par forme bilinéaire (nous aurons l'occasion de retrouver celle définie en géométrie un peu plus tard dans cette page).

f(x,y) =0

Généralisons de manière totale ce concept,avec les applications n-linéaires. Une application n-linéaire est une application prenant "n" vecteurs de "n" espaces vectoriels sur un même corps vers un autre espace vectoriel sur ce corps, qui est linéaire en chaque variable. Une application n-linéaire est donc une application qui,quand on la découpe en plusieurs applications avec les autres vecteurs constants (comme vue pour les applications bilinéaires),ne donne que des applications linéaires. Encore une fois,les espaces vectoriels de départ peuvent être tous différents : nous allons ici les noter avec une suite finie "E" (où l'on commence à "1",et où les éléments seront ici notés en majuscule),de dernier indice "n". On note donc :

D =E1X E2X ... X En
f : D ⟶F,(x1,x2,...,xn) ⟶y

Les conditions de linéarité sont exactement les mêmes que pour les applications bilinéaires. Pour la linéarité du i-ème vecteur (avec "i" inférieur ou égal à "n" et supérieur ou égal à "1"), on note :

∀(x1,x2,...,xi+x'i,...,xn) ∈D,f(x1,x2,...,xi+x'i,...,xn) =f(x1,x2,...,x'i,...,xn) +f(x1,x2,...,x'i,...,xn)
∀(x1,x2,...,xi+x'i,...,xn) ∈D,∀a ∈K,f(x1,x2,...,a * x'i,...,xn) =a * f(x1,x2,...,x'i,...,xn)

Ces deux propriétés sont donc vérifiées pour toutes les variables. Encore une fois, la deuxième propriété permet de dire que, si on multiplie "a" par n'importe quel vecteur, alors c'est comme si on le multiplié par toute la fonction, et donc pour n'importe quel autre vecteur quelconque. Comme pour la bilinéarité, on peut raccourcir ces propriétés.

∀(x1,x2,...,xi+x'i,...,xn) ∈D,∀a,b ∈K,f(x1,x2,...,a * xi+b * x'i,...,xn) =a * f(x1,x2,...,x'i,...,xn) +b * f(x1,x2,...,x'i,...,xn)

La démonstration de leur équivalence est l'exacte même que dans les cas de linéarité et bilinéarité. Nous pouvons en plus de ça dégager quelques autres propriétés sur les applications n-linéaires. Par exemple,Une application n-linéaire est dite symétrique si (et seulement si) l'image de plusieurs vecteurs dans un ordre précis par l'application est la même que l'image de ces vecteurs où vous permutez 2 vecteurs par rapport à l'ordre de départ. Il s'agit d'une sorte de commutativité. Pour que cela soit possible,il faut que les éléments qu'on permutant soient dans l'exact même ensemble. Généralement,on ne se limite pas qu'aux éléments qu'on permutent,mais à tous les vecteurs de départ de l'application (qui irait donc de "E exposant n" vers "F").

∀(u1,...,un) ∈En,∀i,j ∈{1,...,n}
f(u1,...,ui,...,uj,...,un) =f(u1,...,uj,...,ui,...,un)

Si nous pouvons faire une permutation entre deux éléments sans changer la valeur,on peut rajouter une permutation entre deux autres éléments à notre version déjà permutée,et faire plusieurs permutations (2,3,81...). En fait,toutes les permutations possibles des vecteurs donnent le même résultat. Or,le concept de permutation est formalisé en mathématique (sous la forme d'une bijection allant d'un ensemble vers lui même),et l'on peut donc utiliser ce formalisme pour énoncer une formule précise :

∀s ∈S({1,...,n}),f(us(1),...,us(n)) =f(u1,...,un)

Si nous avons une symétrie,nous avons aussi une antisymétrie. Ici,Une application n-linéaire est dite symétrique si (et seulement si) l'image de plusieurs vecteurs dans un ordre précis par l'application est l'opposée (par la première loi de l'espace vectoriel d'arrivé) de l'image de ces vecteurs où vous permutez 2 vecteurs par rapport à l'ordre de départ. Dans ce cas,on note :

∀(u1,...,un) ∈En,∀i,j ∈{1,...,n}
f(u1,...,ui,...,uj,...,un) =-f(u1,...,uj,...,ui,...,un)

Ici,si nous faisons une permutation entre deux vecteurs,nous obtenons l'opposé. Or,si nous faisons cette permutation,et que nous lui ajoutons une autre permutation entre deux autres vecteurs,nous obtenons l'opposé de la permutation (qui représente l'opposé de l'image des vecteurs dans l'ordre de départ) : nous obtenons donc l'opposé de l'opposé de l'image des vecteurs dans l'ordre de départ : qui équivaut donc exactement à l'image des vecteurs dans l'ordre de départ. Ici,on peut donc dégager une propriété assez simple : si vous avez une image de vecteurs dans un ordre de départ, effectuer un nombre impair de permutations donnera l'opposé de l'image des vecteurs dans l'ordre de départ, et effectuer un nombre pair de permutations donnera exactement l'image des vecteurs dans l'ordre de départ. Cependant,on peut encore en soutirer une formule par rapport aux permutations,grâce à la signature d'une permutation. Pour rappel,. On peut donc écrire :

∀s ∈S({1,...,n}),f(us(1),...,u(n)) =ε(s)f(u1,...,un)

De manière similaire,on peut définir les application n-linéaire dites alternées. Une application n-linéaire est dite alternée si l'image de vecteurs est égale à 0 si deux vecteurs de ces sont égaux. Par exemple,"f(u,v,w,u)" serait donc égal à 0.

∀(u1,...,un) ∈En,∀i,j ∈{1,...,n}
∃k,l ∈{1,...,n},[k ≠l ∧uk=ul] ⇒f(u1,...,un) =0

D'ailleurs, si deux vecteurs dans le calcul sont liés (et donc, que un des vecteurs représente l'autre multiplié par un scalaire précis) donne aussi un résultat nul (puisque l'on peut décomposer l'application pour obtenir la propriété que nous venons juste de voir). Donc, on en déduit directement que si un de ces vecteurs est le vecteur nul, l'image est elle aussi nulle.

∃k,l ∈{1,...,n},∃a ∈K,[k ≠l ∧uk=a * ul] ⇒f(u1,...,uk,...,ul,...,un) =f(u1,...,a * ul,...,ul,...,un) =a * f(u1,...,ul,...,ul,...,un) =a * 0 =0

On peut (dans la même idée) directement en déduire que les applications n-linéaires alternées sont stable par la multiplication par un scalaire. Cependant,on peut aussi démontrer que les applications n-linéaires alternées sont stables par addition. Ceci fait donc de l'ensemble des applications n-linéaires une sous-espace vectoriel dans applications n-linéaires tout court.

(f +g)(u1,...,un) =f(u1,...,un) +g(u1,...,un)

D'ailleurs,on peut en déduire un résultat assez intéressant : toute application alternée est antisymétrique.

[k ≠l ∧uk=ul] ⇒f(u1,...,un) =0
⇒f(u1,...,ui,...,uj,...,un) =a
⇒f(u1,...,ui+(uj- ui),...,uj+(ui- uj),...,un) =b
⇒f(u1,...,ui,...,uj,...,un) +f(u1,...,ui,...,(ui- uj),...,un) +f(u1,...,uj- ui,...,uj,...,un) +f(u1,...,uj- ui,...,ui- uj,...,un)
⇒a +f(u1,...,ui,...,(ui- uj),...,un) +f(u1,...,uj- ui,...,uj,...,un)
⇒a +f(u1,...,ui,...,ui,...,un) - f(u1,...,ui,...,uj,...,un) +f(u1,...,uj,...,uj,...,un) - f(u1,...,ui,...,uj,...,un)
⇒-f(u1,...,ui,...,uj,...,un) =-a =b

Dans le cas des applications linéaires et des applications multilinéaires,nous avons vu qu'il est possible d'obtenir toutes les images de ces applications grâces aux bases : c'est la même chose dans le cas d'une application n-linéaire. Bien que la façon d'obtenir cette formule est exactement la même que dans le cas linéaire et bilinéaire,dans le cas des applications "n-linéaire",elle devient bien plus infernal à écrire. En effet,chaque vecteur a sa propre décomposition,avec une quantité inconnue de vecteurs,et donc d'espaces vectoriels de départ,qu'il faut nommer correctement...

f : (E1,E2,...,En) ⟶F
∀m ∈{1,2,...,n},∀u ∈Em,∃(x1, m,x2, m,...) ∈KDim(Em),u =∑k=1Dim(Em)xk, mbk, m
f(u1,...,un) =f(∑k1=1Dim(E1)xk1, 1bk1, 1,...,∑k=1Dim(En)xkn, nbkn, n)
f(u1,...,un) =∑k1=1Dim(E1)...∑kn=1Dim(En)f(xk1, 1bk1, 1,...,xkn, nbkn, n)
f(u1,...,un) =∑k1=1Dim(E1)...∑kn=1Dim(En)∏xkj, jf(bk1, 1,...,bkn, n)

Ici,si tous les espaces vectoriels de départ de type "E indice i" sont le même (que nous allons noter "E"), on peut simplifier la formule. En effet,on peut la simplifier en ne spécifiant qu'une base pour tous les vecteurs (qui est donc une base de "E").

f : En⟶F
∀m ∈{1,2,...,n},∀u ∈E,∃(x1, m,x2, m,...) ∈KDim(E),u =∑k=1Dim(E)xk, mbk
f(u1,...,un) =∑k1=1Dim(E)...∑kn=1Dim(E)(∏xkj, j)f(bk1,...,bkn)

Bien évidemment,sauf dans certains cas ultra précis,cette formule ne nous servira pas. D'ailleurs,on peut simplifier cette formule dans le cas où l'application est alternée, dans le cas où "n = Dim(E)" et où l'espace d'arrivée est le corps des scalaires (et donc où l'application multilinéaire est une forme multilinéaire). Pour cela,nous devons faire plusieurs observations. Premièrement,toutes les itérations de "f(b indice k de 1, ..., b indice k de n)" s'annulent quand deux de ces vecteurs sont égaux. Comme tous les "b indice i" sont linéairement indépendant entre eux,la seule raison que "f" s'annule soit que deux fois le même vecteur de la base soit présent dans "f". Si l'application s'annule,elle rend toute la partie avec le produit nulle,quel que soit la valeur des éléments dans ce produit. Ici,comme "n =Dim(E)",l'application prend autant de vecteur qu'il n'y a de vecteurs dans la base : l'application n'est donc pas nulle si tous les vecteurs de la base apparaissent exactement une fois dans l'application. Aussi,l'ensemble des cas possibles où l'application n'est pas nul est l'ensemble des ordres possibles de vecteurs de la base (qui est un n-uplet),qui peut donc s'obtenir grâce à l'ensemble des permutations de "{1,...,n}". Donc,nous pouvons réecrire cette formule comme la somme de tous les produits de coordonnées où "k indice j" représentant (si l'on note la permutation "p") "p(j)" par (toujours, où l'on remplace "k indice i" par "p(i)") "f(b indice p(1), ..., b indice p(n))". En plus de ça,comme l'application est antisymétrique,cette application ne peut qu'avoir deux valeurs : la valeur dans l'ordre de départ des éléments de la base,et son opposé. Comme nous l'avons vue plus tôt,si "p" est paire,alors la valeur ne change pas,et si "p" est impaire,on a l'opposé. Donc,nous pouvons rajouter la signature au produit pour compter cet opposé, et seulement utiliser "f(b indice 1, ..., b indice n)". Au final,tout ce que nous venons de dire donne cette formule :

f(u1,...,un) =(∑s=S(n)0∏xs(j), j)f(b1,...,bn)

Donc,toutes formes multilinéaires alternées est entièrement déterminée par l'image des vecteurs "e". Or,pour chaque valeur du corps des scalaires,on peut parfaitement définir une application multilinéaire telle que l'image des vecteurs de "e" soit ce scalaire. Dans l'autre sens,pour toute application multilinéaire,il existe un scalaire tel que l'image des vecteurs de "e" soit ce scalaire. Via notre formule vue plus haut,le scalaire obtensible via l'application est unique,et réciproquement l'application obtenue via le scalaire est unique. Par les propriétés de multilinéarité,on peut vite déduire que additionner deux scalaires revient à additionner les formes multilinéaires qu'ils représentent,et multiplier un scalaire par un scalaire revient à multiplier la forme multilinéaire qu'il représente. Donc,l'ensemble des formes n-linéaires alternées sur un espace vectoriel de dimension "n" est isomorphe à l'espace vectoriel "F" de l'ensemble "K" sur le corps "K".

An(E,K) F

Prenons le choix d'une base fixe "e". Parmi toutes ces formes,l'une d'elle est très intéressante : le déterminant. Le déterminant d'une base "e" dans un espace vectoriel "E" est l'unique forme multilinéaire alternées sur "E" tel que l'image des vecteurs de "e" vaut "1". Généralement,il est noté "det indice e".

dete(e1,...,en) =1

Généralement,il est aussi courant de trouver une notation utilisant une sorte de tableau (un peu comme les matrices). Dans le cas de vecteur de R exposant 3,on peut donc voir :

det(u,v,w) =A =|xx'x''yy'y''zz'z''|

Les formes quadratiques

Après les applications linéaires,parlons d'un autre type d'application sur des espaces vectoriels : les formes quadratiques. Une forme quadratique est une application allant d'un espace vectoriel sur un corps "K" vers le corps "K", qui se comporte comme une combinaison linéaire de tous les produits possibles entre des coefficients dans le vecteur qui forment des monômes de degré 2 (ce qui fait de la formule de la forme quadratique un polynome homogène de degré 2). Par exemple,dans "R exposant 3",un exemple de forme quadratique (probablement le plus standard d'ailleurs) peut-être :

q(v) =q(x,y,z) =x² +y² +z²

Cependant,ce n'est pas la définition officielle,qui est elle plus précise. En effet,Une forme quadratique est une application allant d'un espace vectoriel sur un corps "K" vers le corps "K", telle qu'il existe une forme bilinéaire et symétrique tel que pour tous les vecteurs de l'espace, l'image de ce vecteur par la forme quadratique est égale à l'image de deux fois ce vecteur dans la forme bilinéaire.

∃b : V ×V ⟶K
∀u ∈V,q(u) =b(u,u)

Les matrices en algèbre linéaire

Retour sur les matrices

Les matrices sont des objets très utilisées en algèbre linéaire. Pour rappel (comme définit au chapitre 1),Une matrice à valeur dans un ensemble représente intuitivement un tableau de valeurs de cet ensemble. Nous ne reviendrons donc pas ici sur la définition des matrices,que nous avons déjà présenté au chapitre 1. Ici,il faut voir "tableau" comme un tableau à deux entrées,contenant donc des éléments de cet ensemble.

A =[1234]
a1, 1=1
a1, 2=2
a2, 1=3
a2, 2=4

Comme pour beaucoup d'objets mathématiques,il est possible de faire des opérations avec ces matrices. Si votre matrice est à coefficient sur un ensemble muni d'une addition,alors nous pouvons y définir une opération très utile : l'addition matricielle. En effet,l'addition matricielle est une opération entre deux matrices d'exacte même dimension, où chaque élément d'indice "a, b" du résultat représente la somme des éléments d'indice "a, b" des deux matrices. Cette opération est généralement utilisée quand les coefficients sont des nombres. D'un point de vue définition,on peut noter la valeur de chaque élément de la matrice obtenue "C" pour l'addition de matrices "A" et "B" :

ci, j=ai, j+bi, j

On peut même aller plus loin que ça. Selon les propriétés algébriques de l'ensemble de départ des matrices,on peut leur en déduire des propriétés précises,et bien plus complexes qu'une simple addition. Effectivement,si votre ensemble de départ peut former une structure algébrique précise possédant (au moins) une loi de composition interne, alors il est possible d'induire cette loi sur l'ensemble des matrices de même dimension, où chaque élément d'indice "a, b" du résultat représente la valeur après l'opération des éléments d'indice "a, b" des deux matrices. Cette propriété est immédiate de la façon même dont on écrit les éléments dans l'addition. Grâce à ça,on peut rendre cette addition plus permissive.

ci, j=ai, j# bi, j

Nous pouvons définir une autre opération assez utile : la multiplication par un scalaire. Pour la définir,repassons dans un ensemble de matrices à coefficients dans un ensemble muni d'une opération de multiplication (généralement à gauche). Ici,la multiplication par un scalaire est une opération entre un élément de l'ensemble des coefficients (nommé un scalaire) et une matrice, où chaque élément d'indice "a, b" du résultat représente le produit de l'élément d'indice "a, b" et du scalaire. D'un point de vue définition,on peut noter la valeur de chaque élément de la matrice obtenue "C" pour la somme du scalaire "s" et de la matrice "A" :

ci, j=s * ai, j

Ici,il est difficile d'aller aussi loin que pour l'addition. Généralement,pour que cela fonctionne, il est conseiller de définir vos matrices sur un ensemble représentant un anneau ou un corps (généralement commutatif), pour que les propriétés de la multiplication soient justement aussi permissive que dans des anneaux ou des corps. Le corps commutatif le plus utilisé en pratique est bien évidemment le corps des réels.

M(m, n)(ℝ)

Vous l'aurez peut être deviné : avec ces deux lois, si l'ensemble de vos éléments de départ est un corps, nous pouvons définir l'ensemble des matrices de dimension "(m, n)" comme un espace vectoriel de l'ensemble de départ. En effet,si l'ensemble de départ est un corps,l'addition matricielle est un groupe abélien,et la multiplication par un scalaire est associative,distributive et admet un neutre : il s'agit donc bien d'un espace vectoriel. Avec ça,on peut déduire un isomorphisme assez évident : si l'ensemble des matrices de dimension "(a, b)" est un espace vectoriel sur un corps "K", il est isomorphe à l'espace vectoriel usuel sur "K" formé par "K exposant a * b". Ce résultat est encore plus évident si vous travaillez sur des matrices lignes ou des matrices colonnes.

Les espaces colonnes

Quand on a une matrice à coefficients dans un corps "K",on peut découper cette matrice comme une matrice ligne de matrices colonnes. Ici,si "K" est un corps commutatif,on sait que l'on peut munir l'ensemble des matrices colonnes d'une structure d'espace vectoriel sur "K". Avec ceci,on peut définir un concept important : l'espace colonne. Un espace colonne d'une matrice à coefficients dans un corps commutatif "K" représente un espace vectoriel sur "K", qui représente l'espace vectoriel engendré par l'ensemble des matrices colonnes de la matrice. Il s'agit donc d'un sous-espace vectoriel de l'ensemble des matrices colonnes de taille "n" sur "K". Si l'on nomme l'espace colonne "C" et la matrice "A",on peut noter :

C =Vect(Col(A))

Il est possible que "C" représente l'espace entier des matrices colonnes de taille "n" sur "K", comme un sous-espace vectoriel strict. On peut prendre un exemple de matrice où "C" n'est pas l'espace entier des matrices colonnes de taille "n" sur "K" :

A =[12510]
[10]=a * [15]+b * [210]⇒a * [15]+b * 2 * [15]
⇒[10]=(a +b * 2) * [15]

Dans ce cas,il n'existe pas de nombre tel que,si on le multiplie à au vecteur colonne à droite du calcul,on obtient le vecteur colonne à gauche du calcul : ce vecteur n'est pas dans l'espace colonne. Ici,cet espace colonne est donc un espace vectoriel,qui a donc une dimension. Généralement,la dimension de l'espace colonne est nommée le rang de la matrice.

[210]=2 * [15]⇒Vec(([15],[210])) =Vec(([15]))⇒Rg(A) =1

Le produit matriciel

Parlons d'une autre opération sur les matrices,plus complexe mais très utile : le produit matriciel. Le produit matriciel est une opération entre deux matrices de dimension "a, b" et "b, c", donnant une nouvelle matrice de dimension "a, c" où chaque élément représente une somme de produits d'éléments de lignes et de colonnes.

Soyons plus précis, avec une représentation graphique de deux matrices "A" et "B" de dimension "m, n" et "n, p", dont on va obtenir le produit matriciel.

L'idée ici est de définir une valeur précise pour chaque "c" de la matrice obtenue. En fait,pour un "c indice i, j", l'idée va être d'obtenir la somme du produit de chaque valeur de la "i-ième ligne" de la matrice à droite à la position "k", et de la "j-ième" colonne de la matrice en haut encore à la position "k".

ci, j=∑k=1na(i,k)b(k,j)

Généralement, pour deux matrice "A" et "B", le produit matriciel de ces deux matrices se note comme une opération standard, utilisant généralement un "*", ou un "X".

C =A * B

Prenons un exemple avec deux matrices simples :

A =[1234]
B =[0210]

Ici, nous pouvons très facilement calculer chaque valeur de la matrice résultat, et donc obtenir la matrice résultat.

c1, 1=a1, 1* b1, 1+a1, 2* c2, 1=1 * 0 +2 * 1 =4
c1, 2=a1, 1* b1, 2+a1, 2* c2, 2=1 * 2 +2 * 0 =2
c2, 1=a2, 1* b1, 1+a2, 2* c2, 1=3 * 0 +4 * 1 =4
c2, 1=a2, 1* b1, 2+a2, 2* c2, 2=3 * 2 +4 * 0 =6
C =[4246]

Quelque chose de très pratique : ce produit matriciel est associatif.

A * B =C ∧(A * B) * D =E
⇒ci, j=∑k=1na(i,k)b(k,j)∧ei', j'=∑k'=1nc(i',k')d(k',j')
⇒ei', j'=∑k'=1n(∑k=1na(i',k)b(k,k'))d(k',j')
⇒ei', j'=∑k'=1n(∑k=1na(i',k)b(k,k')d(k',j'))
⇒ei', j'=∑k=1n(∑k'=1na(i',k)b(k,k')d(k',j'))
⇒ei', j'=∑k=1na(i',k)(∑k'=1nb(k,k')d(k',j'))
(A * B) * C =A * (B * C)

Parmi toutes les matrices utilisables avec des produits matriciels,une catégorie se détache : les matrices identités. Une matrice identité de taille "n" est une matrice carrée de dimension "(n, n)", constitué du neutre de la multiplication de son corps de départ (donc "1" si le corps est "R") sur sa diagonale, et de l'absorbant de la multiplication de son corps de départ (donc "0" si le corps est "R") partout ailleurs. Une matrice identité (qui se note généralement "I indice c") serait donc :

I3=[100010001]

Quelque chose d'intéressante : faire le produit matriciel de n'importe quel matrice "B" et de la matrice identité (de taille rendant le calcul compatible) dans tous les sens possibles donne "B". La matrice identité représente donc le neutre du produit matriciel.

A * I =A,I * B =B

Ici,on peut voir quelque chose de très pratique : toutes les valeurs non-nulles de la matrice identité sont sur la diagonale allant de en haut à gauche à en bas à droite (appelée diagonale principale). On peut généraliser ce concept,avec les matrices diagonales. Une matrice diagonale est une matrice carrée où tous les coefficients qui ne sont pas sur la diagonale sont non-nuls. Cette définition n'empêche pas certains coefficients de la diagonale principale à être nul. Si votre matrice n'est pas carré,le concept de "diagonale principale" n'est pas définie.

D =[2000-50004]

D'ailleurs,faire le produit d'une matrice par une matrice diagonale quelconque revient à obtenir une matrice où les colonnes de votre première matrice sont multipliées par les valeurs dans la diagonale de la même colonne. En plus,à l'inverse,faire le produit d'une matrice diagonale par une matrice quelconque revient à obtenir une matrice où les lignes de votre deuxième matrice sont multipliées par les valeurs dans la diagonale de la même ligne. La démonstration (présente juste ici) utilise les propriétés du produit matriciel.

[1111]* [300-2]=[3-23-2]
[300-2]* [1111]=[33-2-2]

Ce type de matrice nous permet de facilement définir un concept très important avec les matrices : la trace. La trace d'une matrice carrée représente la somme de tous les éléments de sa diagonale principale. Pour une matrice carré "A" de hauteur "n",on note sa trace "Tr(a)",et on peut noter :

Tr(A) =∑k=1nak,k

D'ailleurs,pour deux matrices carrés de même taille "A" et "B", la trace de "A * B" et la même que celle de "B * A"démontré ici. On peut prouver très facilement que la trace représente une forme linéaire allant de l'espace vectoriel des matrices carrés de hauteur "n" vers leur corps de départ.

Tr(A +B) =∑k=1n(ak,k+bk,k) =∑k=1n(ak,k) +∑k=1n(bk,k) =Tr(A) +Tr(B)
Tr(c * A) =∑k=1n(c * ak,k) =c * ∑k=1nak,k=c * Tr(A)

Avec tout ça,on peut définir quelque chose de très intéressant : les matrices inversibles. Une matrice inversible est une matrice carrée de taille "n" telle qu'il existe une autre matrice carrée de taille "n", tel que leur produit matriciel (dans les deux sens possibles) donne la matrice identité de taille "n". Donc,pour une matrice "A",la condition pour qu'elle soit inversible serait :

∃B ∈Mn,A * B =B * A =In

Pour une matrice donnée,l'inverse de cette matrice est unique. La démonstration est très simple,et repose sur l'idée que si l'on a deux matrices quelconques qui sont des inverses de notre matrice de départ,elles sont forcément égales.

A * B =B * A =In∧A * C =C * A =In
⇒B * A * C =B * (A * C) =B * I =(B * A) * C =I * C ⇒B =C

Généralement,la matrice inverse d'une matrice "A" se note "A exposant -1". D'ailleurs,on peut très vite voir que l'inverse de l'inverse de "A" est donc la matrice qui donne l'identité quand on la multiplie à gauche ou à droite par l'inverse de l'inverse de "A" : l'inverse "A". Donc,l'inverse de l'inverse de "A" est "A", ce qui fait de l'inversion de matrice un opération involutif.

A * A-1=A-1* A =I
(A-1)-1=A

Ici,on peut voir que "B" est aussi inversible,et admet "A" comme inverse. D'ailleurs,faire le produit de deux matrices inversibles donne une nouvelle matrice inversible. La démonstration est très simple :

A * C =E ⇔A * C * D =A =E * D ⇔A * B =I =E * D * B ⇔E * D * B =I
A * C =E ⇔B * A * C =C =B * E ⇔D * C =I =D * B * E ⇔D * B * E =E * D * B =I

Un exemple de matrice inversibles sont les matrices diagonales.

Les matrices inversibles sont stables par le produit matriciel,associative,admettent un neutre et chaque matrice admet un inverse. Donc,nous pouvons définir un groupe sur ces matrices (avec le produit matriciel) : le groupe général linéaire. Il se note généralement "Gl(n,K)",où "n" représente la taille des matrices et "K" le corps de coefficient des matrices.

Gl(n,K)

Une autre opération possible avec une matrice est la transposition. La transposée d'une matrice représente une nouvelle matrice, où les colonnes de cette matrice sont les lignes de la matrice de départ (et donc, où l'on échange les lignes et les colonnes de la matrice). Donc,pour une matrice de dimension "m,n",sa transposée est de dimension "n,m". Généralement,pour une matrice "A",la transposée de "A" se note "A" avec un petit "T" en haut à droite de "A".

A =[1234]
AT=[1324]
B =[123456]
BT=[135246]

Le lien matrice - application linéaire

Il est possible de lier les matrices avec les applications linéaires de manière très pratique. En effet,le produit matriciel permet de voir une chose : faire le produit matriciel d'une matrice quelconque avec une matrice colonne revient à obtenir une nouvelle matrice colonne représentant une combinaison linéaire des colonnes de la matrice de départ. Or,pour rappel,les matrices forment un espace vectoriel (et donc les matrices colonnes aussi). Donc,une matrice peut se représenter comme une application allant d'un espace de matrices colonnes à un autre espace de matrices colonnes. D'ailleurs,la réciproque est vraie : toute application linéaire entre deux espaces de matrices colonnes peut s'exprimer sous la forme de matrice(démontré ici). De plus,cette application est linéaire. Tout cela se définit directement,en utilisant la définition du produit matriciel.

A =[c...d.........e...f]
A * [x...y]=x * (c,...,d) +... +y * (e,...,f)
A * ([x...y]+[w...z]) =(x +z) * (c,...,d) +... +(y +w) * (e,...,f) =x * (c,...,d) +y * (e,...,f) +z * (c,...,d) +w * (c,...,d) =A * [x...y]+A * [z...w]
A * (k * [x...y]) =k * x * (c,...,d) +... +k * y * (e,...,f) =x * (k * c,...,k * d) +y * (k * e,...,k * f) =(k * A) * [x...y]

Généralement,l'image de cette application est nommée "espace colonne" de la matrice. Immédiatement,on peut voir que les colonnes de la matrice sont une famille génératrice de l'image de l'application que représente la matrice.

A =[1234]
A * [ab]=a * [13]+b * [24]

Ici,cet espace colonne est donc un espace vectoriel,qui a donc une dimension. Généralement,la dimension de l'espace colonne est nommé le rang de la matrice.

Rg(A) =2

En algèbre linéaire,il existe plein d'opérations sur les matrices,qui permettent de trouver d'autres propriétés utiles sur ces dernières. Ici,une des opérations les plus importantes de ce style revient à trouver le rang / l'espace colonne d'une matrice. Pour cela,nous allons procéder par des opérations qui ne modifient pas le rang / l'espace colonne de la matrice.

Déjà,il existe un type précis de produit matriciel qui ne modifie pas le rang de la matrice. En effet,faire le produit matriciel à droite ou à gauche d'une matrice avec une matrice inversible ne change pas le rang de la matrice de départ. L'explication est toute simple : faire ce produit matriciel revient à obtenir la matrice associé à l'application composé de notre matrice de départ et de notre matrice inversible. Or,l'application de la matrice inversible est un isomorphisme linéaire. En fait,l'espace des coordonnées de départ et d'arrivée d'un isomorphisme linéaire sont toujours les mêmes. Donc,un isomorphisme linéaire ne modifie pas l'espace des coordonnées d'arrivée / espace des coordonnées de départ (et donc,pas sa dimension non-plus),et sa matrice associée non-plus. Donc,faire le produit matriciel à droite ou à gauche d'une matrice avec une matrice inversible ne change pas le rang de la matrice de départ.

Une autre de ces opérations est la permutation de colonnes. En effet,permuter les colonnes d'une matrice revient à permuter deux vecteurs dans la famille génératrice de l'image de l'application, ce qui peut demander de changer les bases de départ / arrivé, mais ne change pas les indépendances linéaires possibles dans cette famille génératrice, et donc ce qui ne change pas le rang de la matrice (et ce qui ne change pas l'espace engendré non-plus).

M =[1234]
N =[2143]
Rg(M) =Rg(n),M . (1,0) =N . (0,1)

Une autre opération de ce genre est la multiplication de tous les éléments d'une colonne par un scalaire non-nul précis. En effet,multiplier tous les éléments d'une colonne par un scalaire nol-nul revient intuitivement à agrandir / rétricir cette colonne, ce qui ne change pas la façon dont elle est linéairement indépendante (ou pas) des autres colonnes (et ce qui ne change ni la dimension, ni l'espace engendré par la matrice).

M =[1110]
N =[2120]
Rg(M) =Rg(n),M . (2,0) =N . (1,0)

Finalement,nous pouvons trouver une dernière opération utile de ce genre : additionner / soustraire des colonnes de la matrice par d'autres colonnes de la matrice. En effet,soustraire / additionner des colonnes à une autre colonne ne change pas la façon dont elle est linéairement indépendante (ou pas) des autres colonnes (si elle l'est au départ, alors elle le restera même après cette opération), ce qui ne change ni la dimension, ni l'espace engendré par la matrice. Avec ces 3 opérations,on peut déjà commencer à entrevoir la méthode générale pour travailler avec des matrices.

M =[15210]
N =[551010]
P =[50100]
Rg(M) =Rg(N) =Rg(P)

En effet,ici,on peut voir que le vecteur (5, 10) seul génère un espace vectoriel de même dimension que l'espace vectoriel engendré par notre matrice de départ (comme l'autre vecteur est nul, on peut le passer) : elle est de rang 1. Avec ça,nous pouvons introduire un algorithme très utile en algèbre linéaire : l'échelonnement vertical. L'échelonnement vertical (aussi nommé réduction verticale) est une méthode de transformation d'une matrice en une matrice échelonnée, qui permet de plus facilement déduire des résultats sur la matrice de départ. Cette méthode s'inspire d'une autre méthode plus connue (la méthode du pivot de Gauss),que nous verrons plus tard. En tout cas,l'idée de l'échelonnement vertical est assez simple. Premièrement,nous allons repérer la colonne qui contient comme coefficient le plus haut le premier coefficient (en partant de la gauche) non nul,et nous allons permuter cette colonne avec la première colonne. Si la première colonne admet un coefficient le plus haut non-nul,alors pas besoin de faire cette étape. Deuxièmement,nous allons effectuer les opérations nécessaire (multiplication, puis addiction / soustraction) sur les colonnes à droite de notre colonne actuelle pour que tous les coefficients à droite du coefficient le plus haut valent 0. Attention : il ne faut pas modifier que ce coefficient,mais toute la colonne en même temps. Finalement,on ré-itère l'opération, en ne choisissant plus le coefficient le plus haut, mais le deuxième plus haut, et en ne commençant pas par la première colonne, mais par la deuxième. En suite,faites cela jusqu'à que vous arriviez en bas de votre matrice, où tout à droite de votre matrice.

Ici,toutes ces opérations ne modifient pas le rang de la matrice, et en plus ne modifient pas l'espace engendré par la matrice. C'est cela qui rend cet algorithme si efficace : vous pouvez déduire ces deux propriétés dans une matrice de départ grâce à lui. Prenons un petit exemple avec une matrice de rang 2,mais où il est difficile de le voir directement :

[1-203-1042-95]

Ici, la première étape ne sert à rien : le coefficient le plus haut de la première colonne est non-nul. Passons à la deuxième : nous devons soustraire à la deuxième colonne la première colonne multipliée par "-2". En suite, nous devons soustraire la troisième colonne par la première colonne multipliée par "0".

[1003-442-55]

maintenant, passons à la partie 2. Encore une fois, la première étape ne sert à rien : le coefficient le "deuxième" plus haut de la deuxième colonne est non-nul. Passons à la deuxième : nous devons soustraire à la troisième colonne la deuxième colonne multipliée par "-1".

[1003-402-50]

Or, cette matrice génère donc un espace vectoriel généré par deux vecteurs de coordonnées, et a le même rang et génère le même espace vectoriel que notre matrice de départ : notre matrice de départ est donc de rang 2, et son image est engendrée par les deux vecteurs de coordonnée "(1, 3, 2)" et "(0, -4, -5)" dans la base d'arrivée.

Bon,ici,nous travaillons sur les colonnes. Or,il est généralement conseillé de plutôt travailler sur des lignes. Pour comprendre comment cela est possible,il existe une visualisation mentale très simple,permettant de le comprendre et de le démontrer très facile. Consédirons une matrice quelconque,et sa matrice transposée. Par définition,dans une matrice transposée,les lignes de notre matrice de départ deviennent les colonnes de la transposée. Donc,les lignes de la matrice de départ génèrent l'exact même espace que les colonnes de la matrice transposée. Or,comme on l'a vue,les opérations sur les colonnes ne modifient ni le rang,ni l'espace engendré de la matrice. La matrice transposée obéit aussi à cette règle : les opérations sur ces colonnes ne modifie pas son espace engendré. Or,les colonnes de la matrice transposée représentent les lignes de la matrice de départ : les opérations sur les colonnes de la matrice transposée reviennent à faire des opérations sur les lignes de la matrice de départ,qui laissent donc l'espace qu'elles engendrent invariant. Donc,l'espace engendré par les lignes de la matrice de départ ne change pas quand on y applique les mêmes opérations que celles sur les lignes.

Nous pouvons aussi déduire un autre résultat très intéressant en algèbre linéaire : l'espace engendré par les lignes a l'exacte même dimension que l'espace engendré par les colonnes. En fait,ce résultat est parfaitement équivalent à dire qu'une matrice a le même rang que sa matrice transposée. La démonstration est particulièrement ennuyante à écrire,mais sa compréhension brute est assez simple. Commençons par le cas des matrices carrées. Pour une matrice carrée,si cette matrice ne peut pas être raccourcie par échelonnement vertical et sa transposée non plus, elle a donc le même rang que sa matrice de départ, et donc les lignes et les colonnes ont elles aussi le même rang. Cependant,si par échelonnement vertical,on obtient (de notre matrice carrée) une matrice moins large,la situation se complique. Or,nous pouvons transposer cette matrice (pour en faire une plus large que haute), l'échelonner verticalement, pour en obtenir une nouvelle matrice carrée, et y appliquer le même constat. Dans tous les cas,si on trouve la matrice carrée finale,on sait qu'elle a la même dimension que sa transposée. Cependant,la matrice non échelonnée a elle aussi le même rang que la matrice carrée,et sa transposée. Dans ce cas,sa transposée représente une modification par des opérations sur la matrice carrée transposée qui ne changent pas le rang : elle est donc de même rang que sa matrice de départ.

Le lien applications linéaires - matrices

En algèbre linéaire,il existe un moyen de construire une matrice en utilisant une application linéaire. En effet,Une matrice associée à une application linéaire est une matrice dont les propriétés internes permettent de calculer facilement l'image (dans un espace vectoriel de dimension finie) d'un vecteur (toujours dans un espace vectoriel de dimension finie), en transformant les coordonnées du vecteur dans une base de départ en les coordonnées de l'image demandée dans une base d'arrivée. Déjà,pour comprendre cette définition,nous devons avoir en tête un résultat primordial : pour tous vecteurs,ses coordonnées dans une base "b" de taille "n" peut s'écrire comme une matrice colonne de dimension "n". Ici,une matrice prend les coordonnées d'un vecteur exprimé dans une base de départ,et permet d'obtenir les coordonnées de son image (via une application linéaire précise) dans une base d'arrivée. Donc,la matrice représente un moyen de modifier correctement les coordonnées de départ en les coordonnées d'arrivée, en sachant la base de départ, d'arrivée et l'application linéaire auquelle elle correspond. Généralement,une matrice de ce type est notée avec un nom,sa base de départ et sa base d'arrivée (en indice) puis (entre parenthèse) l'application linéaire qu'elle représente.

Mb, c(f)

Chose intéressante : notre matrice ici à la même largeur que la taille de la base de départ "b", et la même hauteur que la taille de la base d'arrivée "c". Elle représente donc une application linéaire entre un espace de matrice colonne de taille "b" et un espace de matrice colonne de taille "c". Par isomorphisme,on obtient qu'elle représente donc aussi une application linéaire entre un l'espace vectoriel usuel de "K exposant b" et l'espace vectoriel usuel de "K exposant c",et donc (toujours par isomorphisme) d'un espace vectoriel de dimension "b" vers un espace vectoriel de dimension "c". On peut donc lier la dimension de la matrice à la dimension de l'espace de départ et d'arrivée. Cela n'est vrai que parce les colonnes représentent une base,et est donc libre.

Ici,nous allons essayer de faire une chose précise : construire intuitivement ce genre de matrice,pour comprendre comment elles fonctionnent. Commençons par le cas le plus simple : passer de coordonnées d'un vecteur base quelconque aux coordonnées dans la base canonique. Ici,ce passage représente l'application linéaire identité de l'espace vectoriel de départ, en changeant juste la base (base donnée vers base canonique, qui représente donc l'écriture directe du vecteur). Donc,l'idée est de modifier les coordonnées de la base de départ, en les transformant en les coordonnées dans la base canonique. Imagineons que nous avons des coordonnées précises dans la base "b",que nous voudrions convertir dans la base canonique. Nous pouvons donc facilement calculer son vecteur associé.

v =∑k=1nakbk
⇔vi=∑k=1nak(bk)i

Or,nous savons que les coordonnées du vecteur dans la base canonique ont les mêmes valeurs que les éléments dans le vecteur. Nous avons donc bel et bien dresser une façon de faire permettant de convertir facilement un vecteur. Cependant,on peut aller plus loin, en essayant de rendre cette façon de faire graphique. Pour cela,nous allons utiliser des matrices. Présentons notre résultat comme ceci,en mettant les vecteurs de la base "b" en colonne :

Nous avons présenté nos coordonnées de départ comme une matrice colonne,et nous avons mis nos bases dans une matrice précise (où chaque vecteur de la base est en colonne). Finalement,nous avons dans nos cases en bas à droite les coordonnées du vecteur recherché,sous la forme d'une matrice ligne. Graphiquement parlant,pour une case du vecteur recherché en bas à droite,obtenir sa valeur revient à prendre une à une les valeurs de sa ligne dans la partie bleue,de faire les produits avec l'élément d'indice l'élément actuellement traitée dans la ligne de la partie bleue,et de tous les sommer. En fait,il s'agit simplement du produit matriciel d'une matrice constituée des éléments de la base (en colonne) par la matrice représentant les coordonnée de départ, donnant la matrice coordonnées d'arrivée. D'ailleurs,cette matrice est aussi large que haute (conséquence du fait que toutes les bases ont la même taille),et les colonnes représentent une base (et pas qu'une famille génératrice) de l'espace colonne : elle représente un automorphisme linéaire.

Tentons l'opération inverse : trouver les coordonnées dans une base donnée de vecteurs de coordonnées dans la base canonique. Encore une fois,ce passage représente l'application linéaire identité de l'espace vectoriel de départ, en changeant juste la base (base canonique vers base donnée, qui représente donc l'écriture du vecteur dans la base donnée). Donc,il ne s'agira que d'un simple changement de base. Pour rappel,si nous nommons notre base donnée "b",chaque valeur du vecteur "v" peut s'écrire :

vi=∑k=1nak(bk)i

Donc,nous obtenons tout un système, contenant un nombre "n" correspondant à la taille de "b" d'équations, et autant d'inconnus. Nous pouvons donc en extraire les coordonnées nécessaires,représentant toutes les valeurs de "a" nécessaires. Imagineons que nous faisons cela pour trouver les coordonnées des vecteurs de la base canonique dans la base "b". Appelons ces vecteurs "c de i",où "i" représente le "i-ième" vecteur de la base.

ci=∑k=1nak(bk)i

Ici,chaque coordonnées "c de i" représente les coordonnées du "i-èmes" vecteur de la base canonique dans la base "b". Donc,exprimer des coordonnées de cette base dans la base canonique (avec les calculs vues plus haut) revient à exprimer des coordonnées de la base canonique en des coordonnées de la base "b". En effet,ici,si vous cherchez la combinaison linéaire de vecteurs (ayant des coordonnées connues dans la base "b") pour obtenir leurs coordonnées dans la nouvelle base "c",vous obtenez en résultat les coordonnées du vecteur dans la base "b". Il s'agit donc de la réciproque du calcul de coordonnées pour un vecteur donné dans une base. Nous pouvons donc écrire "v" comme une combinaison linéaire de vecteurs de "c" et de coordonnées,que nous nommerons "d".

vi=∑k=1ndk(ck)i

Avec ça,la conversion "base canonique" - "b" est assurée. Comme pour plus haut,on peut écrire ce type de calcul avec une nouvelle matrice, non plus composer des éléments de "b", mais composer des éléments de "c". D'ailleurs,cette matrice est aussi large que haute (conséquence du fait que toutes les bases ont la même taille),et les colonnes représentent une base (et pas qu'une famille génératrice) de l'espace colonne : elle représente un automorphisme linéaire.

Ici,nous avons construit un type très précis de matrice : des matrices de changement de base. Une matrice de changement de base (ou matrice de passage) est une matrice carrée permettant d'obtenir les coordonnées d'un vecteur dans une base "c", via l'expression de ce vecteur dans une autre base "b". Ces matrices représentent donc l'application identité,dans des bases différentes d'un même espace vectoriel. Comme vue plus haut,ce type de matrice sont en plus des automorphismes linéaires. Intuitivement parlant,comme deux bases d'un même espace vectoriel génère le même espace vectoriel, ont a donc une application allant de l'espace de départ vers l'espace de départ : il s'agit donc d'une bijection linéaire d'un espace vers lui même, et donc d'un automorphisme linéaire. Par exemple,dans "R²",la matrice passant de la base "(1,0),(1,1)" à la base canonique serait :

A =[1101]

Finalisons cette construction intuitive, avec un exemple plus global. Considérons une application linéaire "f", allant d'un espace vectoriel "E" vers un espace vectoriel "F" (sur un corps "K"). Ici, nous allons considérer les bases comme quelconques. Considérons "b" une base de "E".

b =(b1,b2,...,bn) ∈En
∀v ∈E,∃(a1,a2,...,an) ∈Kn,v =a1* b1+a2* b2+... +an* bn

Selon un théorème vue plus haut,l'image des vecteurs de "b" forme une famille génératrice de l'image de "f". Appelons cette image "c".

c =(c1,c2,...,cn) ∈Fm
∀v ∈F,{v ∈Im(f) ⇔∃(a1,a2,...,an) ∈Kn,v =a1* c1+a2* c2+... +an* cn}

Donc, pour tout vecteur "v" de "E", "f(v)" peut s'écrire comme une combinaison linéaire de vecteurs de "c". Par linéarité de "f", les coordonnées de "v" dans "b" sont les mêmes que les "coordonnées" de "f(v)" dans "c".

f(v) =f(∑k=1nak* bk) =∑k=1nf(ak* bk) =∑k=1nak* f(bk) =∑k=1nak* ck

Nous obtenons donc une expression de "f(v)" dans "c". Cependant,nous avons un problème : nous ne savons pas si "c" est une base de "Im(f)" ou pas, car rien ne nous dit qu'elle est libre. Or,rappelons nous que tout vecteur d'un espace vectoriel peut s'exprimer avec une base de cet espace vectoriel,et que tout espace vectoriel possède au moins une base. Donc,chaque "c" peut s'exprimer comme coordonnées dans une base de l'espace vectoriel d'arrivée,que nous nommerons "d". Nous pouvons définir cette base comme bon nous semble,mais utilisons ici la façon la plus "globale".

∃(e1,e2,...,em) ∈Kn,ci=∑k=1mek* dk

Reformulons donc "f(v)" :

f(v) =∑k=1nak* ck=∑k=1nak* ∑l=1mek - l* dl=∑k=1n(∑l=1mak* ek - l* dl) =∑l=1m(∑k=1nak* ek - l* dl) =∑l=1m(∑k=1nak* ek - l) * dl

Ici,nous pouvons reconnaitre que la somme utilisant "n" représente un produit matriciel de deux matrices : l'une correspondant à la conversion des vecteurs de "c" en vecteurs de "d" via les "e",et l'autre correspondant à "a". Donc,donc, il s'agit de la conversion des "coordonnées" dans la famille "c" vers les coordonnées dans la base "b".

Appelons les (très moches) valeurs de ce résultat par "z". Au final :

f(v) =∑k=1nzk* dk

Donc,nous avons obtenu via les coordonnées de "v" dans "b" les coordonnées de "f(v)" dans une base "d" de "Im(f)". Ici,comme "f" est quelconque,on peut en déduire que tout "f" (et donc toute application linéaire allant d'un espace vectoriel de dimension finie vers un espace vectoriel de dimension finie) admet une matrice. Intuitivement parlant,les colonnes de la matrices représentent une famille génératrice de l'image de l'application. Remarquons quelque chose d'intéressant : nous pouvons aussi mettre plusieurs autres coordonnées que les coordonnées "a".

En voyons ça,nous pourrions avoir envie de faire quelque chose : mettre une matrice d'une application linéaire en haut, et une autre matrice d'une application linéaire à gauche. Pour que cela marche sans problèmes,il faut que que l'ensemble de départ de la deuxième application soit l'ensemble d'arrivée de la première.

Ici,on peut voir que notre nouvelle matrice semble être une matrice d'une autre application linéaire. En fait,on peut prouver que cette nouvelle matrice représente la matrice associée à l'application linéaire de la composée des deux applications linéaires de départ(démontré ici).

Matb, d(f ∘g) =Matb, c(f) * Matc, d(g)

La réduction des endomorphismes

L'un des cauchemars des étudiants en mathématiques en études supérieures est la réduction des endomorphismes. En fait,La réduction des endomorphismes est un procédé qui consiste à transformer des endomorphismes quelconques en des endomorphismes plus simples (si possible). Pour cela,il existe beaucoup de techniques différentes,plus ou moins utiles et simples.

Une première façon de faire utilise le concept de diagonalisation. . De plus,Une matrice carrée est dite diagonalisable si elle est semblable à une matrice diagonale (et donc, que son endomorphisme associé est diagonalisable). Généralement,pour étudier ce genre de propriété,on utilise très souvent la forme matriciel. Si l'on note une matrice "M",elle est diagonalisable si il existe une matrice diagonale "D" tel que :

∃P ∈GLn(K),M =PDP-1

Bon,cette définition ne sert à rien si l'on n'a aucun moyen de savoir si une matrice est diagonale,et de calculer une de ses matrices diagonales. Heureusement,il existe beaucoup de moyens de répondre à ces questions. Pour cela,nous devons définir de nouveaux concepts : les vecteurs / produits / espaces propres. Une valeur propre d'un endomorphisme est une valeur du corps de départ tel qu'il existe un vecteur de l'espace vectoriel de départ tel que son image soit un multiple de la valeur propre. Réciproquement,Un vecteur propre d'un endomorphisme est un vecteur non-nul de l'espace vectoriel de départ tel que son image par l'endomorphisme soit exactement ce vecteur multiplié par un scalaire quelconque. Ici,cette valeur utilisé pour le vecteur propre est donc une valeur propre de l'endomorphisme. Généralement,on parle de vecteur propre associé à une valeur propre précise. Ici,pour un endomorphisme "f",un vecteur "v" est un vecteur propre et une valeur "λ" est une valeur propre "λ" si :

f(v) =λ* v

Il est assez facile de trouver des exemples. En effet, prenons un endomorphisme dans R², transformant "(x, y)" en "(2 * x, y)". Ici, on peut identifier deux vecteurs propres simples : "(1, 0)" et "(0, 1)". De plus, on peut identifier deux valeurs propres : "2" et "1".

f(1,0) =(2,0) =2 * (1,0)
f(0,1) =(0,1) =1 * (0,1)

Pour un endomorphisme,l'ensemble de ces valeurs propres est nommé le spectre de l'endomorphisme. Il se note généralement "Sp".

Sp(f)

Avec tout ça,nous pouvons définir le concept d'espace propre. Un espace propre d'un endomorphisme est un sous-espace vectoriel de l'espace sur lequel l'endomorphisme est défini qui représente l'ensemble des vecteurs propres associés à une valeur propre (auquel on ajoute le vecteur nul). En considérant "u" et "v" des vecteurs propres associés à "λ" et "f" l'endomorphisme utilisé,on peut facilement démontrer que l'ensemble des valeurs propres associées à un vecteur propre est un sous-esapce vectoriel :

u +v =λ* f(u) +λ* f(v) =λ* (f(u) +f(v)) =λ* f(u +v)
∀c ∈K,c * u =c * (λ* f(u)) =λ* (c * f(u)) =λ* f(c * u)

Il existe cependant un autre moyen de représenter cet espace. En effet,pour tout élément de cet espace,l'image de ce vecteur est égal à "λ" fois ce vecteur. Cependant,nous pouvons soustraite le vecteur multiplié par "λ" des deux côtés, pour obtenir une nouvelle expression.

λ* v =f(v) ⇔f(v) - λ* v =0

D'ailleurs, si nous définissons une application "g" telle que "g(v)" est égal au membre à gauche de cette équation, "g" serait une application linéaire. La démonstration est très simple et rapide :

g(v) =f(v) - λ* v
∀u,w ∈E,g(u +w) =f(u +w) - λ* (u +w) =f(u) +f(w) - λ* u - λ* w =f(u) - λ* u +f(w) - λ* w =g(u) +g(v)
∀a ∈K,∀u ∈E,g(a * u) =f(a * u) - λ* (a * u) =a * f(u) - a * λ* u =a * (f(u) - λ* u) =a * g(u)

Ici,il existe une application qui,à "v",y associe "v" : l'identité. Donc,on peut donc échanger "v" par l'application identité, et "f(v)" par "f", pour ne garde que le formalisme des applications. De plus,nous pouvons encore réecrire l'équation en utilisant le formalisme des noyaux,puisque nous cherchons les éléments où cette équation s'annule (et que nous savons en plus que la partie à gauche est une application linéaire). Finalement,on peut écrire que l'espace propre des vecteurs propres associées à "λ" est donc :

ker(f - λ* Id)

Avec ça,nous pouvons étudier les propriétés des valeurs propres en utilisant les propriétés du noyau d'une application linéaire. Par exemple,si ce noyau est réduit au neutre (et est donc de dimension 0),il n'y a pas de vecteurs propres pour "λ" (pour rappel,le vecteur nul n'est pas un vecteur propre). De plus,selon le théorème du rang,si l'application dont on étudie le kernel est de dimension égale à celle de l'espace de départ,son noyau est réduit au nul. Donc,on peut savoir si une valeur est une valeur propre en calculant le rang de l'application que nous pouvons obtenir avec la formule ci-dessus. Pour savoir si le rang de cette application n'est pas selui de l'espace de départ (et donc,que le noyau n'est pas que le vecteur nul),on utilise généralement le déterminant (bien que rien n'empêche d'utiliser une autre technique quelconque). Nous pouvons donc écrire :

λ∈Sp(f) ⇔Det(f - λ* Id) =0

Avec cette propriété,on va pouvoir introduire une façon très pratique d'obtenir les valeurs propres d'une matrice : le polynôme caractéristique. Le polynôme caractéristique d'une matrice.

Les espaces de Hilbert et la géométrie euclidienne

Les espaces vectoriels normés

Grâce aux concepts que nous allons introduire maintenant,nous allons pouvoir nous rapprocher vers une formalisation précise de la géométrie. Déjà,commençons à nous intéresser au concept de norme. En fait,. Il faut faire attention : cette application n'est pas un opérateur entre deux vecteurs quelconques : elle n'est donc pas une distance. Pour qu'une application allant de l'espace vectoriel à l'ensemble des réels positifs soit une norme,elle doit respecter quelques propriétés,similaire aux propriétés que doivent respecter une distance. Pour les expliciter,nous allons appeler cette norme "N",et l'espace vectoriel "E". Déjà,cette application est séparée : si un vecteur a pour image "0", il est obligatoirement le vecteur nul de l'espace.

N(x) =0 ⇒0E

En suite,cette application est homogène : si un vecteur a pour image "a", la multiplication de ce vecteur par un scalaire "b" a pour image "|b| * a". Ici,il est important de prendre la valeur absolue de "b",pour ne pas qu'un signe "-" vienne rendre le résultat négatif,ce qui est impossible par définition de cette application.

N(x) =a ⇒N(b * x) =|b| * a

Finalement,cette application respecte une inégalité triangulaire : la norme de la somme de deux vecteurs "x" et "y" est inférieur ou égale à la somme de la norme du vecteur "x" et de la norme du vecteur "y". Comme pour les espaces métriques,cette inégalité triangulaire traduit que le chemin entre "0" et "x +y" est plus court que celui entre "x",0 puis "y" : le chemin direct est plus court que de passer par un autre point.

∀x,y ∈E,N(x +y) ≤N(x) +N(y)

Donc,Un espace vectoriel normé est un espace vectoriel muni d'une norme. Ici,un exemple s'impose pour mieux illustrer tout ça : prenons l'espace vectoriel "R²" du corps formé par "R". La question ici : comment définir une "norme" d'un élément de "R²" ? En fait,nous allons essayer de représenter cette norme comme la distance entre le vecteur que nous cherchons et le vecteur nul (que nous pourrions théoriquement obtenir avec une mesure à la règle en géométrie pure),de manière algébrique. La façon généralement utilisée est la méthode utilisant le théorème de Pythagore : nous n'allons pas encore l'utliser pour l'instant.

L'espace vectoriel normé de dimension fini le plus simple à définir est probablement celui muni d'une norme précise : la norme 1. Un espace vectoriel normé avec la norme 1 est un K-espace vectoriel normé de dimension fini "n" et de type "K exposant n" où la norme d'un vecteur quelconque représente la somme des valeurs absolues des coefficients qui constituent le vecteur. Pour que cela marche,il faut que le corps de départ soit muni d'une "valeur absolue",comme dans "Q" ou dans "R". On peut asssez facilement démontre que l'application associant à chaque vecteur de l'espace la somme des valeurs absolues de ses coefficients est une norme.

f : Kn⟶R,(a,b,...,c) ∈Kn⟶|a| +|b| +... +|c|

Déjà, la séparation est évidente : si une somme de valeurs positives est nulle, alors tous les éléments de la somme le sont aussi.

|a| +|b| +... +|c| =0 ⇒a =0,b =0... c =0 ⇔(a,b,...,c) =(0,0,...,0)

L'homogénéité est, elle aussi, assez évidente, et se déduit par une simple factorisation.

f((a,b,...,c)) =d ∧f(q * (a,b,...,c)) =e ⇒|a| +|b| +... +|c| =d ∧|q * a| +|q * b| +... +|q * c| =e ⇒|q| * |a| +|q| * |b| +|q| * |c| =|q| * (|a| +|b| +... +|c|) =|q| * d =e ⇒f(q * (a,b,...,c)) =|q| * f((a,b,...,c))

L'inégalité triangulaire n'est pas bien plus compliqué à démontrer, mais demande un peu plus d'éléments.

f((a,b,...,c)) =d ∧f((e,g,...,h)) =i ⇒|a| +|b| +... +|c| =d ∧|e| +|g| +... |h| =i ⇒f((a,b,...,c) +(e,g,...,h)) =|a +e| +|b +g| +... +|c +h|
|a +e| ≤|a| +|e| ∧|b +g| ≤|b| +|g| ∧... ∧|c +h| ≤|c| +|h| ⇒|a +e| +|b +g| +... +|c +h| ≤|a| +|e| +|b| +|g| +.. +|c| +|h| ⇒f((a,b,...,c) +(e,g,...,h)) ≤f((a,b,...,c)) +f((e,g,...,h))

Cette norme peut s'illustrer assez facilement en 2D.

Les espaces de Hilbert et le produit scalaire

Axiomatiquement parlant, introduire la géométrie n'est pas chose aisée. Cependant, nous allons pouvoir commencer sérieusement à s'y pencher, grâce aux espaces pré-hilbertiens, aux espaces de Hilbert et au produit scalaire.

Commençons par définir le concept de produit scalaire. Un produit scalaire est une opération bilinéaire, symétrique et définie positive sur un espace vectoriel, qui prend donc deux vecteurs de l'espace et donnant comme résultat un scalaire positif du corps de l'espace vectoriel. Ici,il nous faire définir chaque terme de la définition,pour bien la comprendre. Première,il s'agit d'une forme bilinéaire,concept qu'on a déja défini plus haut. En gros,si nous définissons le produit scalaire de 2 vecteurs "x" et "y" comme l'image d'une application "f",on peut écrire :

f : E * E ⟶K
f(x +x',y) =f(x,y) +f(x',y)
f(x,y +y') =f(x,y) +f(x,y')
f(a * x,y) =f(x,a * y) =a * f(x,y)

Deuxième,elle est symétrique. Ici,comme pour tout opérateur algébrique, dire que le produit scalaire est symétrique équivaut à dire que le produit de "x" et "y" est le même que celui de "y" et "x" (le sens n'a pas d'importance). Cela veut dire que nous pouvons écrire :

f(x,y) =f(y,x)

Finalement,elle est définie positive. Cependant,il faut savoir que ici,les mots "définie" et "positive" sont un peu bizarre dans le cas des formes linéaires. Déjà,dire qu'une forme bilinéaire est positif équivaut à dire que si vous opérez un élément avec lui même, le résultat sera positif ou nul. Finalement,dire qu'une forme bilinéaire est définie équivaut à dire si vous opérez un élément avec lui même et que le résultat vaut le nul du corps, alors cela veut dire que cet élément vaut le nul de l'espace vectoriel. En fait,dire que le produit est positif,puis définie revient à dire :

f(x,x) ≥0,f(x,x) =0 ⇒x =0

Bon,ici,on peut se demander à quoi va nous servir ce produit. Pour cela,plaçons nous dans un espace vectoriel normé sur "R" de type "R exposant n". Ici,on peut définir une application de cette forme très précise : l'application qui prend deux vecteurs, "envoie" le deuxième sur le premier, et multiplier la norme du vecteur "envoyé" sur le premier par la norme du premier vecteur.

Ici, on peut se demander comment démontrer que cette application est bien une forme linéaire. Pour cela, essayons d'expliciter cette forme dans "R²". Posons deux vecteur "u" et "v" tel que "u" soit "(a, b)" et "v" soit "(c, d)". Pour obtenir le vecteur "v" envoyé sur "u", nous devons décomposer "v" dans une base "u" et "u'", où "u" représente "u" tourné de 90° (et donc, "(-b, a)").

v =e * (a,b) +f * (-b,a)
c =e * a +f * -b
d =e * b +f * a

Essayons de trouver une valeur pour "e" :

c =e * a +f * -b
d =e * b +f * a
⇔
c =e * a +f * -b
f =d-e*ba
⇔
e * a =c - d-e*ba* -b
f =d-e*ba
⇔
e =ca- e*b2a2+d*ba2
f =d-e*ba
⇔
e*(a2+b2)a2=ca+d*ba2
f =d-e*ba
⇔
e * (a2+b2) =c * a +d * b
f =d-e*ba
⇔
e =c*a+d*b(a2+b2)
f =d-e*ba

Ici,la proportition du deuxième vecteur "envoyé" sur le premier est exactement "e". Pour obtenir la norme de ce vecteur envoyé,on doit le multiplier (une première fois) par la norme du premier vecteur. Pour obtenir la valeur démandée que nous avons défini plus haut,nous devons donc le re-multiplier par la norme du premier vecteur. Donc,le produit scalaire de "u" et "v" est donc "e" multiplié par la norme au carré de "u".

u→. v→=e * ||u→||2=e * a²+b²2=c*a+d*b(a2+b2)* a²+b²2=a * c +b * d

Donc, notre application s'explicite de cette façon dans "R²". On peut donc très facilement prouver à partir de là qu'elle est bilinéaire, symétrique et définie positive. Posons un vecteur "w" égal à "(g, h)".

Bilinéaire :

(u→+w→) . v→=(a +g) * c +(b +h) * d =a * c +g * c +b * d +h * d =a * c +b * d +g * c +h * d =u→. v→+w→. v→
u→+(v→+w→) =a * (c +g) +b * (d +h) =a * c +a * g +b * d +b * h =a * c +b * d +a * g +b * h =u→. v→+u→. w→
u→+(i * v→) =a * (c * i) +b * (d * i) =a * c * i +b * d * i =i * (a * c +b * d) =(a * i) * c +(b * i) * d =i * (u→. v→) =(i * u→) . v→

Symétrie et définie positivité

u→. v→=a * c +b * d =c * a +b * d =v→. u→
u→. u→=a * a +b * b =a2+b2≥0
u→. u→=0 ⇒a * a +b * b =0 ⇒a =b =0

Nous pouvons aussi expliciter autre chose : si nous avons deux vecteurs de même taille,leur image par cette application semble changer selon ce que nous pourrons intuitivement observer comme étant "l'angle" entre les deux. En effet,cette application permet de définir la notion "d'angle" dans un espace vectoriel.

Déjà,Un espace pré-hilbertien est un espace vectoriel muni d'une opération entre plusieurs vecteurs vers un scalaire, permettant de formaliser le concept "d'angle" dans cet espace.

Contenu

La géométrie différentielle

L'analyse vectorielle

De l'analyse sur des espaces vectoriels

Ici, nous allons aborder une nouvelle branche de la géométrie particulièrement utile en ingénieurie : la géométrie différentielle. La géométrie différentielle est un type de géométrie possible, ayant pour but d'unir les outils de l'analyse mathématique avec ceux de la géométrie. Pour cela, nous allons retrouver beaucoup de choses que nous avons déjà vue : dérivée, intégrale...

Pour commencer, nous allons aborder ce qui est probablement la branche la plus simple de la géométrie différentielle : l'analyse vectorielle. L'analyse vectorielle est une branche de la géométrie différentielle où nous cherchons à combiner les outils de l'algèbre linéaire avec les outils de l'analyse. Dans une très grand majorité des cas, nous travaillons sur des champs scalaires ou vectoriels réels.

Les champs scalaires et vectoriels

Le concept que nous allons présenté dans ce qui suit est un concept assez utilisé en mathématique, mais surtout infiniment important en mathématiques appliquées, comme en physique Commençons par parles des champs scalaires. Un champ scalaire est une application allant de l'ensemble "R exposant n" vers un ensemble de scalaire, comme "R". Un champ scalaire se note donc :

f : Rn⟶R

Donc, les éléments passés à cette fonction sont des vecteurs de "(R exposant n, +, *)". On peut des fois entendre parler du concept de champ scalaire comme une fonction à plusieurs variables. En fait, cette appelation vient du fait que certains auteurs n'écrivent pas "f((x, y, z))", mais "f(x, y, z)" directement. Ici, une champ scalaire n'est pas forcément une forme linéaire sur l'espace vectoriel de "R exposant n", car il n'est pas forcément linéaire. On peut par exemple imaginer :

f =cos(x) +sin(y)

Si il existe des champs de scalaires, il existe aussi des champs de vecteurs. Un champ de vvecteurs est une application allant de l'ensemble "R exposant n" vers un ensemble "R exposant n".

f : Rn⟶Rn

Comme pour les champs scalaires, On peut des fois entendre parler du concept de champ de vecteur comme une fonction à plusieurs variables(l'explication du pourquoi est la même que pour les champs scalaires). Encore une fois, une champ de vecteur n'est pas forcément une application linéaire, car il n'est pas forcément linéaire. On peut par exemple imaginer (dans "R²") :

f((x,y)) =(x2- y,x +y2)

La dérivation en plusieurs variables

Pour l'instant, nous avons dérivé des fonctions allant de l'ensemble des réels vers l'ensemble des réels. Cependant, il est possible de définir des sortes de dérivations sur des fonctions à plusieurs variables, allant de "R exposant n" vers "R", ou vers "R exposant m".

Commençons par le type de dérivation le plus simple à définir : la dérivée partielle. La dérivée partielle d'une fonction à plusieurs variables par l'une de ses variables "x" est une fonction représentant la dérivée réelle de la fonction de départ, en considérant les autres variables constantes. En d'autres termes, on se ramène à une fonction à une seule variable. Comme pour tout ce qui implique de la dérivation, ce type de dérivé peut être défini en 1 seul point précis, sur toute une partie, ou encore sur tout l'espace entier. D'un point de vue intuitif, la dérivée partielle d'une fonction par rapport à une variable en un point est une représentation de comment l'image de la fonction évolue quand on fait varier de manière infinitésimale le paramètre "x", en laissant les autres constants.

Pour une fonction "f" où l'on veut obtenir la dérivée partielle en une variable "x", on peut utiliser plusieurs notations : nous allons présenter les deux plus utilisées. La première est la notation de Leibniz, exactement comme vue plus haut. La deuxième utilise le même schéma que la notation de Leibniz, en remplaçant le "d" par un symbôle similaire au delta, nommé "d rond".

dfdx=δfδx

Si on veut changer de variable en considérant par exemple une variable "y", on permute donc le "x" et le "y".

dfdy=δfδy

En général, il est forteement conseillé de définir à chaque fois quand / où la fonction est dérivable ou pas dérivable. Prenons un exemple avec un champ scalaire :

f : ℝ3⟶ℝ
f(x,y,z) =x +x * y +x * z

Essayons de calculer sa dérivée partielle par rapport à la variable "x". Pour cela, on peut simplement définir une nouvelle fonction "f indice x" allant de "R" vers "R", où l'on considère "y" et "z" constants, et calculer sa dérivée. La dérivée de cette fonction sera égale à la dérivée partielle de "f" par rapport à "x". Dans ce cas, on voit assez vite que cette fonction est dérivable partout, nous pouvons donc écrire :

fx: ℝ⟶ℝ
∀y,z ∈R,fx(x) =x +x * y +x * z
f'(x) =δfδx=1 +y +z

En procédant de manière similaire, on peut calculer la dérivée partielle de "f" par rapport à "y" et "z". Faisons le en accéléré (notons que ces fonctions sont aussi dérivables sur tout leur ensemble de définition) :

δfδy=x
δfδz=x

Ici, on peut définir les dérivés partielles en utilisant le passage à la limite. Dans ce cas, on peut définir la dérivée partielle d'une fonction "f" allant de "R exposant n" vers "R" ou "R exposant m" (ce qui ne change rien à la définition) par rapport à la "i-ième" variable en un point "(a indice 1, ..., a indice n)" comme ceci :

δfδxi(a) =limh⟶0f(a1,...,aj+h,...,an) - f(a1,...,aj,...,an)h

Encore une fois, cette définition se définit à une partie, voir à tout l'espace si possible. Remarquons quelque chose : une dérivée partielle dans le cas où la fonction va vers "R" donne un nombre réel, et donne un vecteur de "R exposant m" dans le cas où la fonction va vers "R exposant m". Donc, la fonction représentant une dérivée partielle est d'exacte même nature que la fonction de départ.